RAGチャットボットをゼロから構築するのは、もうやめよう
December 8, 2025/12分で読了/Guillaume Bigot
RAG(検索拡張生成)チャットボットは、大規模言語モデル(LLM)に実際のデータを組み合わせることで、スマートかつ根拠のある回答を生成します。推測ではなく、実際の文脈やドキュメント、ログ、FAQを検索し、事実に基づいた回答を生成することで、ハルシネーション(幻覚)を抑え、高速に改善を繰り返し、「実験」ではなく「製品」として通用するAIを実現します。
しかし現実には、多くのRAGチャットボットが高レイテンシーや的外れな回答により失敗しており、チームは追跡も信頼もできないブラックボックスな結果に悩まされています。
技術チームは、開発アプローチの見直しを迫られています。APIやパイプラインをつなぎ合わせるのではなく、DataikuというThe Universal AI Platform™を使えば、モジュール化され、追跡可能で、実運用に対応したRAGチャットボットを設計できます。
一般的なDIY型RAGチャットボットは、ベクターデータベースと少数のドキュメント、LangChainなどのツールを使ったシンプルな構成でスタートします。うまく動くのは、次のような状況になるまでです:
複数のナレッジベースが必要になる
複雑なルーティングが必要になる
チームが監査性やアクセス制御を求めるようになる
ハルシネーション(幻覚)やデータ漏洩が発生し、社内レビューが求められるようになる
こうなると、チームはゼロから書き直すか、生成AIの展開自体を一時停止せざるを得ません。どちらもスケーラブルではありません。
Dataikuを使えば、検索の精度と生成AIの創造性を兼ね備えたRAGチャットボットを構築できます。回答をでっちあげる代わりに、接続されたドキュメント、データベース、APIなどのソースから取得した実データに基づいて出力を生成します。これにより、チーム全体にわたって信頼性や管理性を損なうことなく、より迅速でスマートかつ信頼できるインサイトの提供が可能になります。Dataikuでは、Agent Hubを通じて接続され、Dataiku LLMメッシュによって支えられたエージェントアーキテクチャを用いて、実運用レベルのRAGチャットボットを構築できます。
Dataikuでは、エージェントアーキテクチャーを活用し、Agent Hubで接続され、Dataiku LLMメッシュによって支えられた、実運用レベルのRAGチャットボットをチームで構築できます。
ここでは、Dataikuがもたらす4つの主要なメリットをご紹介します:
データ準備、ナレッジバンク、エージェントはそれぞれ別のDataikuプロジェクト内に存在し、各チームは必要な要素のみにアクセスできます。このモジュール構成により、デバッグや更新が迅速になり、コンポーネント間のエラーリスクが低減され、データエンジニア、アナリスト、AIスペシャリストによる並行開発が可能になります。チームはより迅速に、より賢く協働でき、不要な複雑さなしに制御性を維持できます。
ドキュメントの取り込みはコンテンツの種類に応じて最適化されます。REST API、チュートリアル、特許、メール、会議メモなどは、それぞれ構造を保持すべき部分は残し、構造が少ない部分は「子チャンク」に分割して検索速度を高めつつ、上位レベルの文脈を保持します。その結果、より正確で関連性の高いAI応答が得られ、ハルシネーション(幻覚)も抑制されます。
個人情報の検出、プロンプトフィルタリング、トークンコスト推定などの機能がDataikuに標準で搭載されています。チームは、機密データが保護され、AIの挙動が追跡可能であることを前提に、安心して実験・展開が行えます。
ローコードのビジュアルエージェントでプロトタイピングを行い、複雑なロジックやAPI呼び出し、メモリチェーンなどが必要なワークフローでは、コードベースのエージェントへスムーズに拡張できます。Dataikuなら、1つのプラットフォーム上で(英語)、異なる開発スタイルをシームレスに切り替えながら活用できます。この柔軟性により、あらゆるスキルレベルのチームメンバーが力を発揮でき、チーム間の整合性も保たれ、再開発の手間が減ることで、プロトタイプから本番運用への移行がスムーズかつ効率的になります。
Dataikuで構築された本番対応のRAGチャットボットの多くは、一定のパターンに従っています。
出発点は、キュレーションされたナレッジバンク(KB)です。KBでは文書単位のセキュリティを適用でき、データチームは自動ワークフローを活用して、データの整形、チャンク処理、エンリッチメントを実施し、各KBが正確かつガバナンス対応の状態で検索可能となるよう整備します。
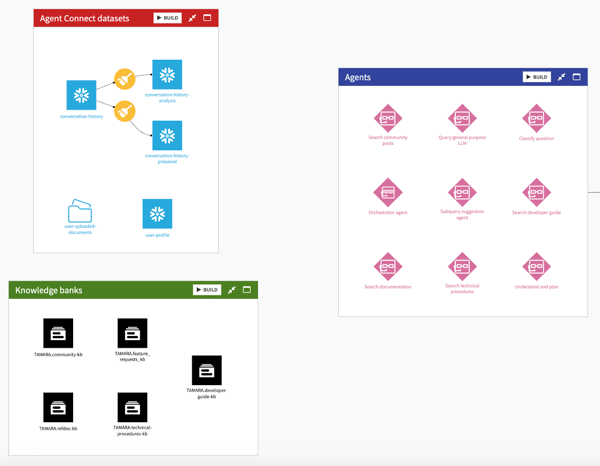
それぞれのKBに対応する専用の検索エージェントが作成され、リンクされます。各エージェントは、割り当てられたドメイン内で検索および応答の合成を行い、開発者、管理者、サポート担当者といったユーザーに、文脈に基づいた回答と出典情報を提供します。
このすべてを裏で統合するのがAgent Hubです。Agent Hubは、同一プロジェクト内でも、別プロジェクト間でも、複数のエージェントをシームレスにオーケストレーションできます。ルーティング、管理、スケーリングを一元的に行えるインターフェースを提供しつつ、チーム間のモジュール性とアクセス制御を保持します。
Agent Hubで公開されるKB検索エージェントは、オーケストレーションされた形で機能します。システムプロンプトはカスタマイズ可能で、ユーザーのクエリーを分析し、その意図、複雑さ、対象ユーザーを判断できます。分析結果に基づき、オーケストレーターが最適なKB検索エージェントを選定して応答を処理します。必要に応じて、クエリーをインデックスに適合させるよう再構成したり、マッチしない場合には汎用LLMへのフォールバックロジックを発動することも可能です。
回答の関連性を高める方法として、システムインストラクションにサブクエリ提案機能を追加し、ユーザーの意図を明確にするフォローアッププロンプトを提示する手法があります。
明確化されたクエリーは、指令LLMに送られます。指令LLMは「理解して計画する」役割を持ち、利用可能なエージェントの評価、呼び出し、推論を行い、最終的に適切な回答をユーザーに返します。重要なのは、すべての回答に出典が付いており、回答生成に使用された文書が明示されているため、ユーザーが安心して信頼できることです。
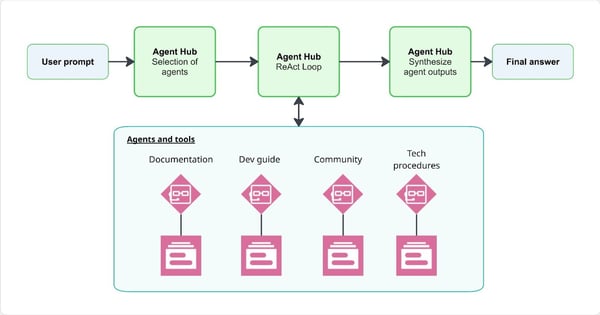
重要なのは、チームがループを閉じる(循環させる)ことです。ユーザーフィードバックを早期かつ頻繁に収集し、「正解データセット(ground truth)」を構築することで、エージェントの精度とパフォーマンスを継続的に評価できるようになります。その結果、RAGチャットボットは単に回答するだけでなく、「根拠」「信頼性」「文脈」を伴った回答を返すようになります。
RAGチャットボットの構築はスタート地点にすぎません。真の成功は、導入後に何が起こるかで決まります。技術アーキテクチャーの構築自体は比較的容易ですが、信頼できる、継続的に改善されるエージェントを維持するには、ユーザー教育、一貫した評価、継続的な改善への意図的な投資が必要です。
初期の盛り上がりが落ち着くと、長期的なパフォーマンスは、「ユーザーがどう使うか」「フィードバックがどれだけ有効に収集されるか」「システムがどれほど早く現場に適応できるか」にかかっていることが明らかになります。以下に、RAGチャットボットを導入後に維持、改善するための3つの基本的な取り組みをご紹介します。
どれほど優れたエージェントでも、その力を引き出すのはユーザーの使い方次第です。多くの性能問題は、モデルの限界ではなく、プロンプトの使い方に起因しています。
「AかBか?」のような二択よりも、「どのような手順ですか?」といった探索型でオープンな質問を推奨しましょう。LLMはどちらも誤りであっても自信満々に回答を選ぶという特性を理解すれば、ユーザーは自然とより良いプロンプト設計と、回答の検証方法を学ぶようになります。
Dataikuでは、こうした教育を体験の中に組み込むことができます。チームは、Dataiku Answersのインターフェース内にヒントや文脈に応じたガイダンスを組み込み、あらゆるクエリーをマイクロトレーニングの機会に変えることができます。この仕組みにより、組織全体にAIリテラシーが浸透し、ユーザーは“盲目的”ではなく“批判的”にエージェントと対話できるようになります。ユーザーが自分のプロンプトに自信を持てるよう、Dataikuでは次のような支援が可能です:
プロジェクト立ち上げを支援する「すぐに使える」プロンプトライブラリにアクセス可能
効果的なプロンプト表現への書き換えを支援する「プロンプトアシスタント」機能を搭載
優れたプロンプトとその出力例を並べて確認し、何が「良いプロンプト」かを理解したうえで、明確な改善を繰り返せます。
この仕組みにより、ユーザーは信頼できるツールやリソースを使って堅牢なプロンプトを作成するスキルを身につけられます。最も優れたエージェントは、「プロンプト作成をスキルとして扱う」チームから生まれます。プロンプトは当てずっぽうで試すものではありません。
導入初期におけるフィードバックは、まさに「金鉱」です。誤作動、誤検出、的外れな回答など、すべてがエージェントを賢くするための貴重なデータポイントです。
Dataikuでは、Dataiku Answersのインターフェース内で組み込みのフィードバック収集機能を有効化でき、ユーザーがリアルタイムで回答に「高評価」または「フラグ付け」を行えます。これらの定性的な反応は即座に、正確度スコア、レイテンシーの傾向、検索品質の指標といった定量的シグナルに変換され、評価パイプラインに直接組み込まれます。
その結果、誤ルーティングされたクエリーや信頼度の低い回答など、全体に影響する問題を早期に特定し、小さな不具合が大きな障害になる前に改善できます。継続的なフィードバックは、「チャットボットの劣化(ドリフト)」を「進化」へと変えてくれます。苦情を待ってから対応するのではなく、初日からフィードバックループを組み込み、改善をシステムのDNAにしましょう。
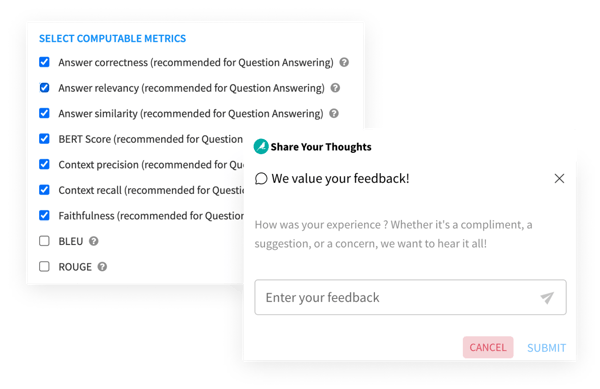
フィードバックデータが蓄積されはじめると、それが「信頼できるベンチマーク」となります。高評価の回答はすべて、「正解データセット(ground truth)」の信頼できる構成要素となり、継続的評価の中核を担います。
これにより、アーキテクチャー、検索手法、チャンク処理戦略、エージェントルーティングロジックなどを並列比較できるようになります。チャンク処理ルールや検索深度の変更が、精度や再現率にどのような影響を与えるかを、時系列で可視化できます。
低評価の回答もまた、同じく貴重なデータです。それらをクラスタリングして分析することで、ナレッジバンクの不足、文脈の不明瞭さ、意図の誤分類など、構造的な課題を特定できます。これらのインサイトは、プロンプトテンプレートの改善からエージェントオーケストレーションの見直しに至るまで、RAG構成の設計改善に直結します。
こうした取り組みによって、RAGチャットボットは単なる静的なツールではなく、学習し、自己修正し、責任を持ってスケールできる適応型システムへと進化します。ベンチマークは点数をつけることが目的ではありません。精度を時間とともに向上させる“フィードバックのフライホイール”を構築することが目的です。
RAGは今や、ミッションクリティカルな業務フローにおける中核機能となっており、従業員に必要な情報への迅速かつ信頼できるアクセスを提供しています。Dataikuの顧客は、日々の業務を効率化するため、これらのRAGチャットボットを本番環境に展開しています。
安全衛生サポートアプリLG Chemは、従業員向けの安全衛生関連ドキュメントの第一対応窓口として、RAGを活用したWebアプリを構築しました。よくある問い合わせへの回答を自動化することで、手動での検索時間を削減し、専門家はより複雑かつリスクの高い課題に集中できるようになりました。
社内業務サポートエージェントファッション業界のある企業では、従業員が社内ポリシー、調達ガイドライン、店舗運営マニュアルなどに即座にアクセスできるよう、チャットボットを導入しました。文書を手動で探す必要がなくなり、該当箇所やガイダンスを即座に取得できることで、業務効率が向上し、日常業務の摩擦も軽減されています。
これらは単なるPoC(概念実証)ではありません。今や、単なる検索を超えた、本格運用型のエージェントへの移行が進んでいます。推論し、自動化し、社内システムと深く統合されたエージェントです。これらのエージェントは、OCRや階層型チャンク処理、文書構造に応じたセグメンテーションといった高度なデータ準備、Agent Hubによるマルチエージェントのオーケストレーション、データアクセス管理のためのガバナンストール、幻覚や古い情報を検知するモニタリング機能など、Dataikuの多彩な機能を活用しています。
いずれのケースにおいても、時間の節約、精度の向上、ナレッジへの自動アクセスという明確なメリットが得られています。