AIエージェントのメモリ:種類、アーキテクチャ、エンタープライズでの検討事項
August 18, 2026/9 min read/Team Dataiku
AIエージェントには、ユーザー、会話、過去の判断を記憶していることが期待されています。顧客に3回目の問題説明を求めるサポートエージェントは、生産性の面で失敗してしまいます。そもそもエージェントを導入する価値そのものを損なってしまいます。
しかし、メモリの仕組みはどれも同じではありません。エージェントが文脈を保持できるのがセッション内なのか、セッションをまたいでなのか、それとも運用履歴全体にわたってなのかは、メモリアーキテクチャによって決まります。そして、それぞれのアプローチには、パフォーマンス、コスト、ガバナンス、データプライバシーの面で異なるトレードオフがあります。
本ガイドでは、AIエージェントのメモリの主な種類、一般的なアーキテクチャ、エンタープライズでの実装パターン、そしてメモリを備えたエージェントを大規模に導入するために必要なガバナンス上の検討事項を解説します。
AIエージェントのメモリとは、エージェントが過去のやり取りから情報を保持、検索するための仕組みであり、継続性、パーソナライゼーション、文脈を踏まえた意思決定を可能にします。
主な種類は2つあります。短期メモリ(セッション単位のコンテキストウィンドウ)と長期メモリ(セッションやワークフローをまたいで存続する永続的なストア)です。
エピソード記憶は過去の出来事の流れを記録し、意味記憶は事実に関する知識を保存します。どちらも、エンタープライズのエージェント設計においてそれぞれ異なる役割を果たします。
メモリアーキテクチャの選択は、コスト(コンテキストウィンドウが大きいほどトークンを消費する)、ガバナンス(永続的なメモリはデータ保持の義務を生む)、パフォーマンス(検索のレイテンシーがエージェントの応答時間に影響する)に直接影響します。
エンタープライズのメモリ設計では、パーソナライゼーションとプライバシーのバランスをとる必要があります。エージェントが何を記憶するかは、どのように忘れるかと同じくらい重要です。
AIエージェントのメモリが重要なのは、ステートレスなエージェントでは、エンタープライズのユーザーや顧客が期待する継続性に応えられないからです。
メモリがなければ、エージェントとのやり取りは毎回ゼロから始まります。カスタマーサポートのエージェントは、顧客が前回のセッションですでに答えた診断のための質問を繰り返します。調達エージェントは、先週すでに評価したサプライヤーの基準を再評価します。社内アシスタントは、ユーザーが昨日提供した文脈を再び求めます。こうしたやり直しのたびに時間が無駄になり、ユーザー体験が損なわれ、エージェントを導入する根拠となった運用上の価値が低下します。
1,300人以上の専門家を対象とした調査に基づくLangChainの2026年「State of Agent Engineering」レポートによると、回答者の3分の1が本番導入の最大の障壁として品質を挙げており、特に大企業では、エージェントの出力が信頼できない主な原因としてコンテキスト管理が挙げられています。
メモリを備えたエージェントは、3つの方法でこのギャップを埋めます。
パーソナライゼーション:エージェントが、ユーザーの履歴、好み、過去のやり取りに基づいて応答を調整します。
運用の効率化:同じ質問の繰り返しが減り、文脈を集めるサイクルが短くなることで、解決が速くなり、やり取り1回あたりのコストが下がります。
コンプライアンスと監査可能性:永続的なメモリにより、エージェントが何を知っていたのか、いつ知ったのか、その情報を判断にどう使ったのかが文書化された記録として残ります。
コスト面のメリットは見落とされがちです。適切に設計されたメモリは、会話履歴全体を渡すのではなく、関連する過去の文脈だけを検索するため、コンテキストウィンドウの消費を減らします。1日に数千件のやり取りを処理するエージェントにとって、この削減はトークンコストの低減に直結します。こうしたメリットを理解するには、まず短期メモリと長期メモリを区別することから始めましょう。
AIエージェントのメモリは、一時的なセッションバッファから永続的な知識ストアまで、幅広いスペクトラムの上で機能します。各ユースケースがそのスペクトラムのどこに位置するかを理解することで、アーキテクチャが決まります。
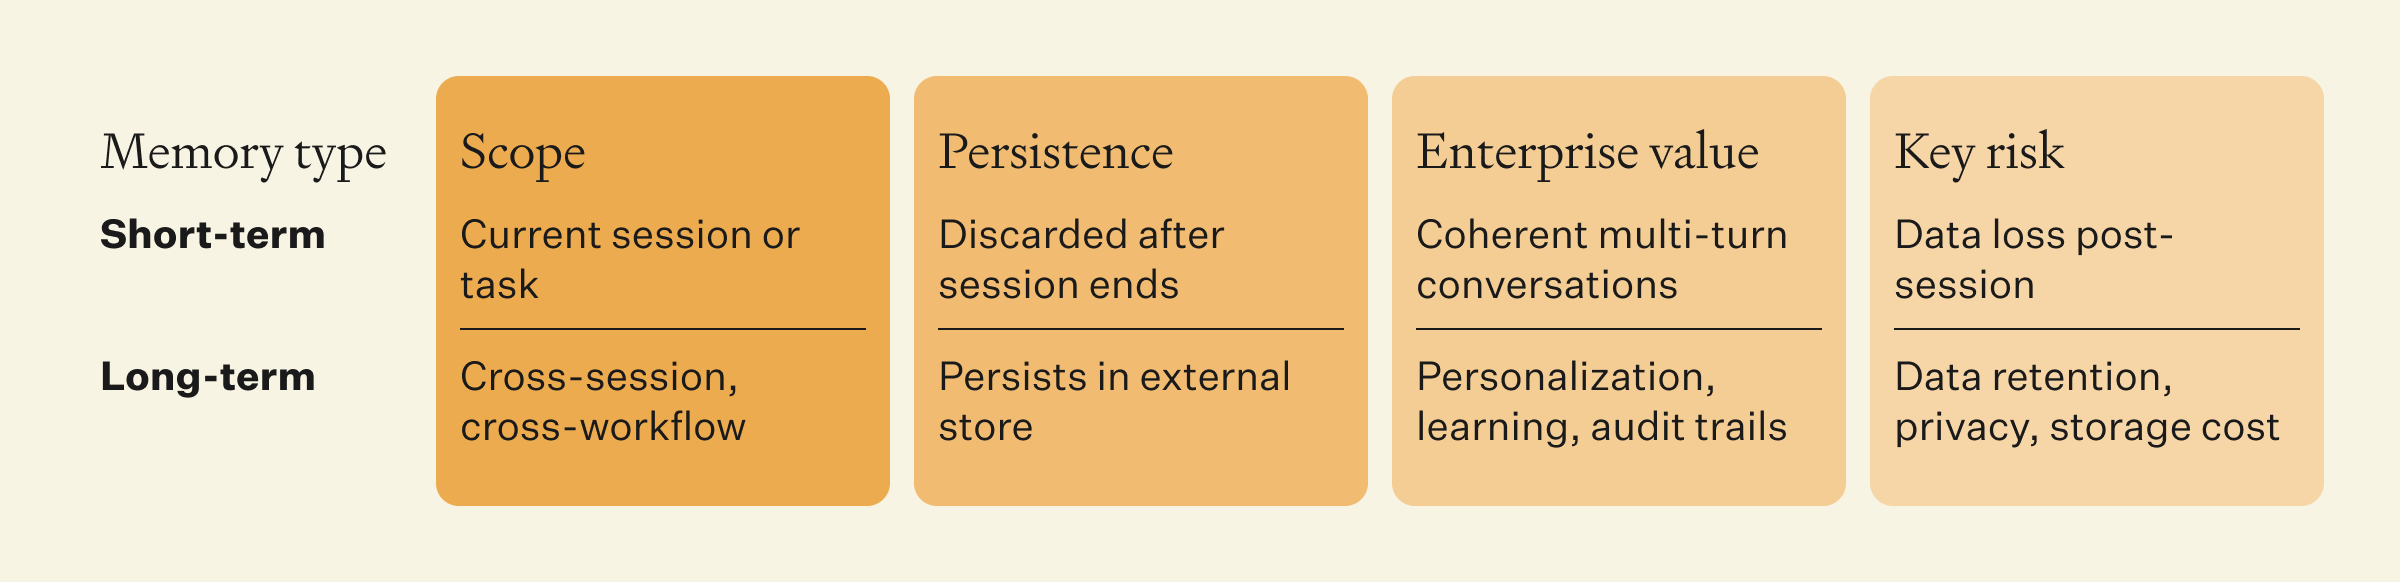
画像をクリックするとPDFで拡大表示できます
短期メモリは、1つのセッションやタスクの実行の中で文脈を保持します。LLMのコンテキストウィンドウ、つまりリクエストごとにモデルに渡される会話履歴、検索されたドキュメント、システム指示を通じて機能します。
メリットはシンプルさです。 モデルは、多くの場合、別途長期的な検索ステップを経ることなく、現在の作業中の文脈に直接アクセスできます。プロンプトに文脈全体が含まれているため、エージェントは会話全体を通じて一貫性を保てます。たとえば、チャットボットは、追加の質問に出てくる「それ」が2つ前のメッセージで話題にした製品を指していることを理解できるため、ユーザーが製品名を繰り返さなくても会話を続けられます。
制約は範囲です。 セッションが終わると、メモリは消えてしまいます。エージェントは次のやり取りを、それまでの経緯を何も知らない状態から始めることになります。1回限りの問い合わせに対応するエージェント(検索アシスタントやコード生成ツールなど)であれば、これで十分です。しかし、ユーザーを記憶したり、進行中の案件を追跡したり、経験から学習したりする必要があるエージェントには不十分です。
長期メモリは、セッション、ワークフロー、時間をまたいで情報を保持します。そのためには外部ストレージが必要です。意味的な検索のためのベクトルデータベース、構造化された関係性のためのナレッジグラフ、トランザクションの記録のためのリレーショナルデータベースなどです。
長期メモリを特徴づける機能は3つあります。
永続性:エージェントが、以前のセッションでの過去のやり取り、判断、文脈を検索できます。
パーソナライゼーション:ユーザーの好み、コミュニケーションのパターン、過去の文脈が時間とともに蓄積され、エージェントの的確さが高まります。
エピソードの想起:エージェントが、特定の過去の出来事を参照できます(「前回このサプライヤーが値上げしたとき、あなたは5%の値上げを承認しました」など)。
ハイブリッドのパターンは、この両方を組み合わせたものです。短期メモリが現在のセッションの文脈を扱い、長期メモリが関連する過去の文脈を検索してそれを補強します。これは、メモリを備えた本番環境のRAGシステムの多くで採用されているアーキテクチャであり、検索されたドキュメントが事実に基づく根拠を、メモリがユーザーとセッションの履歴を提供します。
エンタープライズのエージェントは通常、2つの異なる種類のメモリを活用します。この2つを混同すると、アーキテクチャの判断を誤ることになります。以下の表では、エピソード記憶と意味記憶の違いを、保存、検索、ユースケースの観点から整理しています。
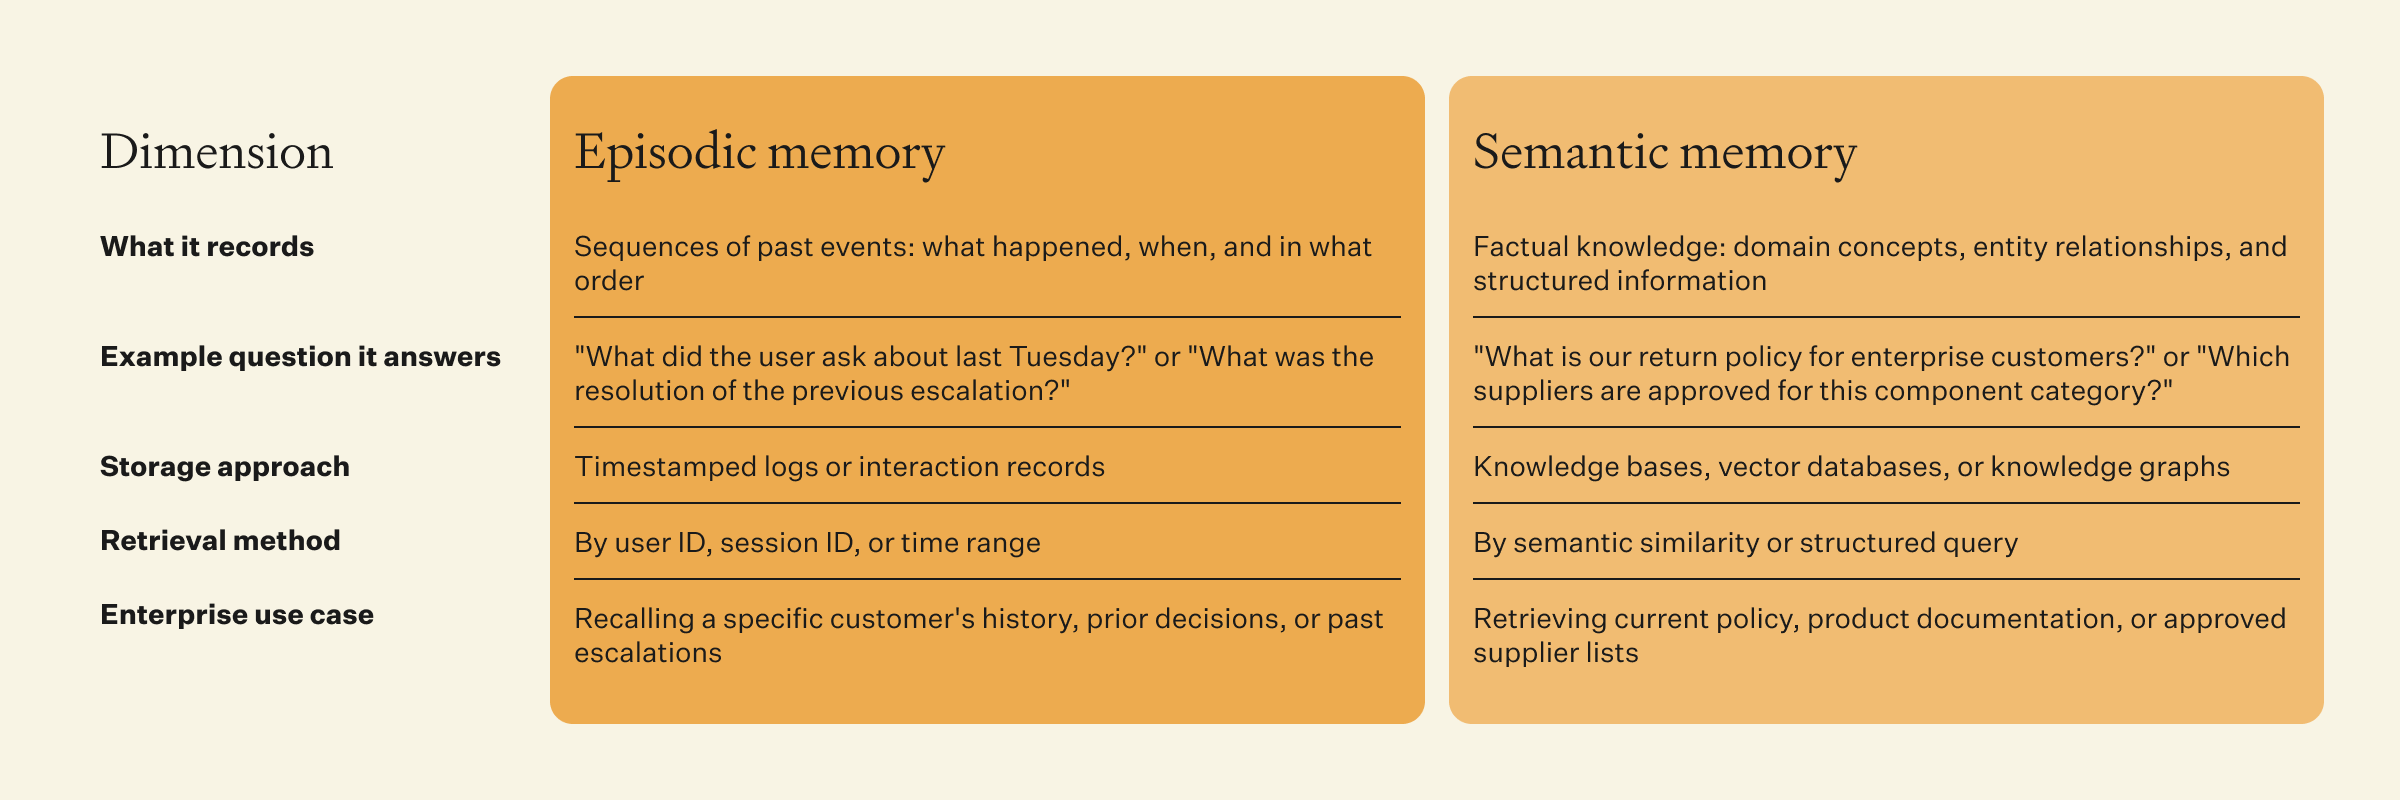
画像をクリックするとPDFで拡大表示できます
どちらの種類もエンタープライズのエージェントに役立ちますが、その目的は異なります。カスタマーサポートのエージェントは、エピソード記憶を使って顧客の過去の問題とその解決方法を想起し、意味記憶を使って最新の製品ドキュメントやポリシー情報を検索します。最も効果的なエージェントは、どちらか一方に頼るのではなく、両方を組み合わせています。
エージェントのメモリを保存、検索するアーキテクチャには3つのアプローチがあり、それぞれに異なるトレードオフがあります。
トークンレベル(インコンテキスト)メモリは、過去のやり取りをLLMのコンテキストウィンドウに直接渡します。外部ストレージも検索システムも不要で、レイテンシーのオーバーヘッドもない、最もシンプルなアーキテクチャです。 制約となるのは、コンテキストウィンドウの上限です。会話履歴が増えるにつれて、コンテキストが埋まっていく(トークンを消費し、コストが増える)か、古い文脈を要約または切り捨てて詳細を失うかのどちらかになります。
パラメトリックメモリは、ファインチューニングによって知識をモデルの重みに直接埋め込みます。情報がモデル自体の一部になっているため、エージェントは「記憶」しているのです。このアプローチは、変化の少ない安定したドメイン知識に適しています。 制約は、パラメトリックメモリを更新するには再トレーニングが必要なことです。再トレーニングはコストが高く、壊滅的忘却(以前に学習した情報を失うこと)のリスクももたらします。
外部(検索ベース)メモリは、情報を外部システム(ベクトルデータベース、ナレッジグラフ、リレーショナルデータベース)に保存し、推論時に検索します。最も柔軟なアーキテクチャで、再トレーニングなしでメモリを更新でき、モデルとは独立してスケールし、標準的なデータ管理のプラクティスでガバナンスできます。 トレードオフは、検索のレイテンシーと、ストレージと検索のパイプラインを維持するためのエンジニアリングの複雑さです。
本番環境のエンタープライズエージェントの多くは、外部メモリとトークンレベルのコンテキスト管理を組み合わせて使用しています。
AIエージェントのメモリの実装で重要なのは、ストレージの技術よりも、ベクトルデータベースを1つ用意する前に行う設計上の判断です。いきなりツール選びから始めたチームは、際限なく肥大化するメモリストア、誤った文脈を返す検索、そして削除リクエストにどう対応するのかについて明確な答えがない状態に陥りがちです。
以下のステップでは、メモリがエージェントのパフォーマンスを高めるのか、それとも単にコストとリスクを増やすだけなのかを左右する設計上の選択を整理します。
すべてを記憶すべきではありません。エージェントが保持する必要のある情報(ユーザーの好み、案件の履歴、判断の結果)と、セッション終了後に破棄すべき情報(途中の推論ステップ、今後価値のないツール呼び出しの応答)を定義します。
保存するすべてのメモリには、user_id、session_id、タイムスタンプ、関連性タグを含めるべきです。メタデータがあれば、絞り込んだ検索が可能になります。エージェントは、メモリストア全体を検索するのではなく、現在のユーザー、タスク、期間に関連するメモリだけを検索できます。
やり取りをそのまま保存すると詳細は保たれますが、ストレージを消費し、検索のノイズも増えます。保存前にやり取りを要約すれば、その両方を減らせますが、ニュアンスは失われます。適切な選択は、下流のユースケースが正確な想起(コンプライアンス、監査)を必要とするのか、おおまかな文脈(パーソナライゼーション、継続性)で十分なのかによって決まります。
メモリの検索は、ユーザー、期間、関連性のしきい値、タスクの種類によって範囲を絞るべきです。エージェントがこれまでに保存したものをすべて返すような絞り込みのない検索は、ノイズを生み、レイテンシーを増やし、無関係な文脈や古い文脈を返すリスクがあります。
際限なく増えていくメモリは、ストレージコスト、検索のレイテンシー、ガバナンス上の負担を生みます。ビジネス要件と規制上の義務に基づいて保持期間を定めましょう。ユーザーの好みのデータは無期限に保持してもよいかもしれません。セッションのやり取りのログは90日後に期限切れにしてもよいでしょう。保持ポリシーは、組織のデータガバナンスフレームワークと整合させる必要があります。
重要な指標は以下の3つです。
再現率(Recall):メモリシステムは、エージェントが必要とする情報を検索できているか?
関連性(Relevance):検索された情報は、現在のタスクに実際に役立っているか?
鮮度(Staleness):検索された情報は今も最新か、それとも元になった事実が変わっていないか?
まずは、意味記憶のMVPから始めましょう。エージェントのドメイン知識を格納し、類似度検索で取り出せるベクトルストアです。意味のレイヤーが安定し、永続的なユーザーデータのためのガバナンスフレームワークが整ってから、エピソード記憶(ユーザーとのやり取りの履歴)を追加します。
Gartner®は、「コストの増大、ビジネス価値の不明確さ、リスク管理の不備により、2027年末までにエージェンティックAIプロジェクトの40%以上が中止される」と述べています(Gartner, Inc.による)*。メモリを備えたエージェントには、ステートレスなエージェントにはないガバナンス上の義務が生じます。
ユーザーとのやり取りを保存する永続的なメモリには、必然的に個人情報が含まれます。ガバナンスフレームワークでは、どのPIIを保存できるのか、それをどのように暗号化するのか、誰がアクセスできるのか、そして削除リクエスト(GDPR第17条、CCPA)にどう対応するのかを定める必要があります。ベクトルデータベースからユーザーのデータを削除するのは、リレーショナルテーブルから行を削除するよりも技術的に複雑であり、ガバナンス計画ではその点も考慮しなければなりません。
メモリストアは、各法域のデータレジデンシー要件に準拠する必要があります。欧州の顧客にサービスを提供するエージェントは、エージェント自体がどこで稼働しているかにかかわらず、欧州のユーザーのメモリを準拠したインフラに保存しなければなりません。
2つのコストカテゴリがせめぎ合います。ストレージコストは、保存されるメモリの量に応じて増加します。トークンコストは、LLMに渡される検索結果の文脈の量に応じて増加します。適切に設計された検索フィルタと要約の戦略によって、このバランスを最適化できます。役立つだけの量を保存し、関連するものだけを検索し、トークン消費を膨らませる不要な文脈を渡さないようにしましょう。
際限なく増え続けるメモリは、検索の品質を低下させ(ノイズが増え、検索が遅くなる)、ガバナンス上の負担を増やします(保護、監査、場合によっては削除が必要なデータが増える)。減衰の戦略を導入しましょう。時間ベースの有効期限、関連性に重み付けした剪定、そして古いメモリをコンパクトな表現に要約する定期的な統合です。
メモリの検索は、テストクエリに対してだけでなく、実際の本番環境の負荷のもとでベンチマークしましょう。毎分100クエリでは許容できる検索のレイテンシーも、毎分10,000クエリでは許容できないかもしれません。100万ベクトルでは良好に動作するストレージシステムも、1億ベクトルでは性能が低下する可能性があります。
AI Successのためのプラットフォームを提供するDataikuは、Dataiku Agent Managementを通じてこの課題に対応します。Dataiku Agent Managementは、あらゆるプラットフォームのエージェントに接続し、ビジネスパフォーマンス、挙動のドリフト、ガバナンスの状況を1つの画面で追跡する、全社的なエージェントの監督を提供します。メモリを備えたエージェントについては、メモリがエージェントのパフォーマンスを高めているのか、それとも時間とともに検索の品質を低下させているのかを可視化することも含まれます。
AIエージェントのメモリは、エージェントをステートレスなツールから、やり取りのたびに改善していく、永続的で文脈を理解するシステムへと変えます。そのビジネスへの影響は測定可能です。繰り返しのやり取りが減り、解決が速くなり、トークンコストが下がり、エンタープライズのユーザーがますます期待するパーソナライゼーションが実現します。
進め方は次の通りです。
1つのワークフローでパイロットを実施する。
まず意味記憶(ドメイン知識の検索)を実装する。
永続的なデータのためのガバナンスフレームワークが整ったら、エピソード記憶(ユーザーとのやり取りの履歴)を追加する。
再現率、関連性、鮮度を測定する。
本番環境で観測された挙動に基づいて改善を繰り返す。
Dataikuは、組み込みの監督、リネージ、そしてあらゆるインフラにわたる監視を備えた、ガバナンスの効いたエージェントワークフローを提供します。これにより、エージェントが記憶する内容も、エージェントが下す判断と同じように適切にガバナンスされます。
Deliver AI agents
Deliver AI agents
[Gartner Newsroom, Gartner Predicts Over 40% of Agentic AI Projects Will Be Cancelled by End of 2027, June 2025]GARTNERは、Gartner, Inc.およびその関連会社の商標です。
AIエージェントのメモリとは、AIエージェントが過去のやり取りから情報を保持、保存、検索できるようにする仕組みです。これにより、エージェントは会話をまたいで文脈を維持し、ユーザーの履歴に基づいて応答をパーソナライズし、過去の判断から学習できます。メモリがなければ、それまでの経緯にかかわらず、エージェントとのやり取りは毎回ゼロから始まります。
メモリに不正確な情報、古い情報、権限のない情報、矛盾する情報が含まれている場合は、高める可能性があります。古いメモリを検索し、それを現在の事実として扱うエージェントは、自信を持って誤った応答を返してしまいます。これを軽減するには、メモリの衛生管理が必要です。時間に左右される情報の有効期限ルール、検索時の鮮度チェック、そして信頼度の低いメモリの優先度を下げる関連性スコアリングです。
コストは2つの変数によって決まります。ストレージ(どれだけ保存するか)と検索(やり取りごとにどれだけの文脈をLLMに渡すか)です。通常はトークン消費のほうが大きな要因であり、処理量に応じて増加します。関連するメモリだけを返す、適切に設計された検索フィルタによってコストを抑えられます。
いいえ。ファインチューニングは、再トレーニングによってモデルの重みを変更するもので、壊滅的忘却のリスクを伴います。エージェントのメモリは情報を外部に保存して推論時に検索するもので、再トレーニングなしでリアルタイムに更新できます。エンタープライズのエージェントの多くは、継続的な知識管理のためにファインチューニングではなく外部メモリを使用しています。
削除の方法は、ストレージのアーキテクチャによって異なります。リレーショナルデータベースでは、ユーザーIDでレコードを削除する必要があります。ベクトルデータベースでは、そのデータから生成されたベクトルを削除する必要があります。要約されたメモリでは、削除対象のユーザーの情報を除いて再生成する必要があります。来歴、識別子、データマップ、そして元のレコードと派生したメモリ成果物とのつながりを維持しておくことで、最初から削除を想定した計画を立てておきましょう。
Tags