セマンティックオブザーバビリティーとAIオブザーバビリティー:生成AI時代に何が変わるのか
August 25, 2026/7 min read/Team Dataiku
生成AI(GenAI)システムは、インフラのチェックをすべて通過しながらも、最も重要な点で誤っていることがあります。応答は時間通りに返され、トークンの予算も守られ、ログにも異常はない。それなのに、回答は6か月前に失効したポリシーを引用している、といった具合です。
従来の監視は、システムの障害を捉えます。しかし、セマンティックな障害、つまり技術的には生成されているものの内容が誤っている出力を捉える仕組みはありません。本番環境の生成AIでは、こうした障害こそがコンプライアンス上のリスクを生み、取締役会への報告にまで上がることが少なくありません。
AIオブザーバビリティーとセマンティックオブザーバビリティーは、この問題の異なるレイヤーに対処するものです。多くの組織はこの2つを混同しています。本記事では、それぞれが何を監視し、どのような障害を捉えるのか、どのような場面でどちらを使うべきか、そして両方をどう導入するかを明確に整理します。
AIオブザーバビリティーは、レイテンシー、トークン使用量、エラー率、コスト、モデルの健全性といったシステムレベルのパフォーマンスを監視します。「システムは正しく稼働しているか?」という問いに答えるものです。
セマンティックオブザーバビリティーは、推論の一貫性、意図との整合性、事実の正確性、意味の維持といった出力レベルの品質を監視します。「システムは正しく適切な出力を生み出しているか?」という問いに答えるものです。
この2つは競合するものではなく、補完し合うものです。セマンティックオブザーバビリティーは、AIオブザーバビリティーを置き換えるのではなく拡張するものです。
ハルシネーション、推論のドリフト、エージェントのループ、検索の不整合といった生成AI特有の障害モードには、従来のパフォーマンス指標では検知できない、セマンティックレイヤーでのチェックが必要です。
まずはAIオブザーバビリティーを基盤として整えましょう。出力がエンドユーザー、ビジネス上の意思決定、規制対象のワークフローに直接影響する場合に、セマンティックオブザーバビリティーを重ねていきます。
オブザーバビリティーを変えなければならないのは、生成AIシステムが、従来のシグナルがすべて正常を示している中でも障害を起こしうるからです。インフラの監視ではそもそも捉えられない形で、自信満々に誤った出力を生み出してしまうのです。
決定論的なソフトウェアは、動くか動かないかのどちらかです。関数は期待される値を返すか、エラーを投げます。決定論的なシステムのオブザーバビリティーは比較的シンプルで、入力、出力、エラーコード、レイテンシーを監視すれば済みます。
生成AIシステムの障害は、それとは異なります。システムは通常の技術的なパラメータの範囲内で稼働し続けながら、意味的に誤った出力を生み出すため、インフラのレベルでは障害が見えないことが多いのです。
2つのシナリオを考えてみましょう。
顧客がAIを活用したサポートエージェントに返金ポリシーについて質問します。エージェントは180ミリ秒で、自信に満ちた文法的にも正しい回答を返しますが、その回答は会社が6か月前に廃止したポリシーを引用しています。インフラの指標はすべて正常であるにもかかわらず、出力は誤っています。
別のシナリオでは、コスト最適化エージェントが価格データベースに問い合わせ、小数点の位置を誤るハルシネーションを起こして、50万ドルではなく5万ドルでのベンダー契約を推奨します。レイテンシーは正常で、トークン使用量も予算内ですが、この小数点1つのずれが財務に与える影響は甚大です。
従来のKPI(稼働時間、レイテンシー、エラー率、スループット)では、こうした障害を捉えることはできません。システムは技術的なレイヤーでは正しく動作しているからです。問題は出力にあり、出力レベルの問題を検知するには、別のオブザーバビリティーのアプローチが必要です。
どちらの障害も、システムレベルでは検知されません。どちらにも、出力レイヤーでのセマンティックオブザーバビリティーが必要です。
AIオブザーバビリティーとは、AIシステムが信頼性と効率性を保ち、定められたコストとコンプライアンスの範囲内で機能するよう、その運用上の挙動を監視、追跡、分析する取り組みです。
AIオブザーバビリティーは、4つのレイヤーで機能します。
インフラレイヤー:GPU使用率、メモリ消費量、APIエンドポイントの健全性、サービスの可用性。これらの指標は、AIシステムを支えるコンピューティング基盤が想定されたパラメータの範囲内で稼働していることを確認します。
モデルパフォーマンスレイヤー:モデルの予測や生成が時間を通じて品質を維持しているかを追跡する、精度、適合率、再現率、ドリフトの指標。生成AIの場合は、応答品質スコアや検索の関連性の指標にまで広がります。
コストと効率のレイヤー:リクエストあたりのトークン使用量、やり取りあたりのコスト、キャッシュヒット率、スループット。これらの指標は、利用規模が拡大してもシステムの運用コストが予算内に収まることを確保します。
コンプライアンスと監査のレイヤー:リクエストのログ記録、アクセス制御の検証、ポリシー遵守のチェック。システムがガバナンスの範囲内で稼働していることを確認します。
AIオブザーバビリティーの主な目的は次の通りです。
パフォーマンスの最適化:システムは十分に速く、正確か?
コストの管理:システムは効率的か?
コンプライアンス:システムはポリシーの範囲内で稼働しているか?
信頼性:システムは負荷がかかっても動き続けるか?
障害の例
本番環境のLLMエンドポイントで、ピーク時にレイテンシーが200ミリ秒から3.2秒に急上昇したとします。AIオブザーバビリティーはこの急上昇を検知し、同時リクエストによるGPUメモリの競合が原因であることを突き止め、オートスケーリングを起動します。障害は技術的なもので、検知は運用上のもの、解決はインフラレベルのものです。AIオブザーバビリティーは、こうしたケースにうまく対処できます。
AIオブザーバビリティーがカバーするのは、運用上の健全性です。応答が正確で、適切で、ユーザーの意図に沿っていたかを判断するには、セマンティックレイヤーが必要です。
セマンティックオブザーバビリティーとは、AIシステムがどのように回答にたどり着いたのか、その出力がユーザーの意図に沿っているか、そして応答の意味が正確で、適切で、信頼できるものかを明らかにする取り組みです。
AIオブザーバビリティーが「システムは応答したか?」を問うのに対し、セマンティックオブザーバビリティーは「システムは正しく、正しい理由で応答したか?」を問います。
セマンティックオブザーバビリティーは、以下の3つのレイヤーで機能します。
モデルの観測可能な推論の過程を段階ごとに記録したものです。どのドキュメントが検索され、どのように順位付けされたのか、どのような中間的な結論が導かれたのか、そして最終的な出力がどのように組み立てられたのかを記録します。これらのトレースにより、モデルの思考プロセスはブラックボックスではなく、検証可能なものになります。
定められた基準に照らして出力をスコアリングする、自動化された品質チェックです。
事実の正確性:応答は検証済みの情報源と一致しているか?
意図との整合性:応答はユーザーが尋ねたことに答えているか?
網羅性:応答はクエリに関連するすべての側面をカバーしているか?
安全性:応答はコンテンツポリシーに準拠しているか?
技術的には正しくても意味的には誤っている出力を、ユーザーやレビュー担当者が指摘するための構造化されたチャネルです。たとえば、尋ねられた質問とは別の質問に答えている応答、最も重要な発見が抜け落ちている要約、事実としては正確でも文脈上は不適切な推奨などです。
セマンティックオブザーバビリティーは、規制の厳しい環境で特に重要です。流暢ではあっても事実に反する推奨を生み出す金融アドバイスのチャットボットは、AIオブザーバビリティーだけでは検知できない法的責任を生みます。検索拡張生成(RAG)を基盤としたナレッジアシスタントが、正しいドキュメントを検索しながらも、それを誤解を招く結論にまとめてしまう場合、そのリスクを捉えられるのはセマンティックレイヤーでの評価だけです。
これは、CIOにとっても抽象的な懸念ではありません。Dataiku/Harris PollによるCIO 600人を対象とした調査に基づく「7 career-making AI decisions for CIOs in 2026」によると、85%が、説明可能性のギャップによってAIプロジェクトの本番化がすでに遅れたり、中止されたりしたと回答しています。
生成AI特有の懸念として、RAGの回答におけるバイアスの増幅があります。検索のステップでバイアスを含むドキュメントが取り出され、生成のステップでそのバイアスが自信に満ちた応答にまとめられると、出力は情報源の限界を反映しながらも、AIシステムとしての権威をまとってしまいます。セマンティックオブザーバビリティーは、正確性とあわせて出力の公平性を評価する評価ループによって、これを検知します。
主な違いは、それぞれのレイヤーが何を監視し、何を捉えるかにあります。AIオブザーバビリティーはシステムの健全性とパフォーマンスを監視し、セマンティックオブザーバビリティーは出力の意味と推論の質を監視します。
チームがこの2つの用語を混同しがちなのは、どちらも本番環境のAIシステムを監視するものであり、どちらもテレメトリとアラートに依存し、どちらもAIシステムの信頼性を保つことを目指しているからです。仕組みが重なっているからこそ、その違いが重要になります。違いは主にツールにあるのではなく、それぞれのアプローチが何を監視し、どのような障害を捉えるかにあるのです。
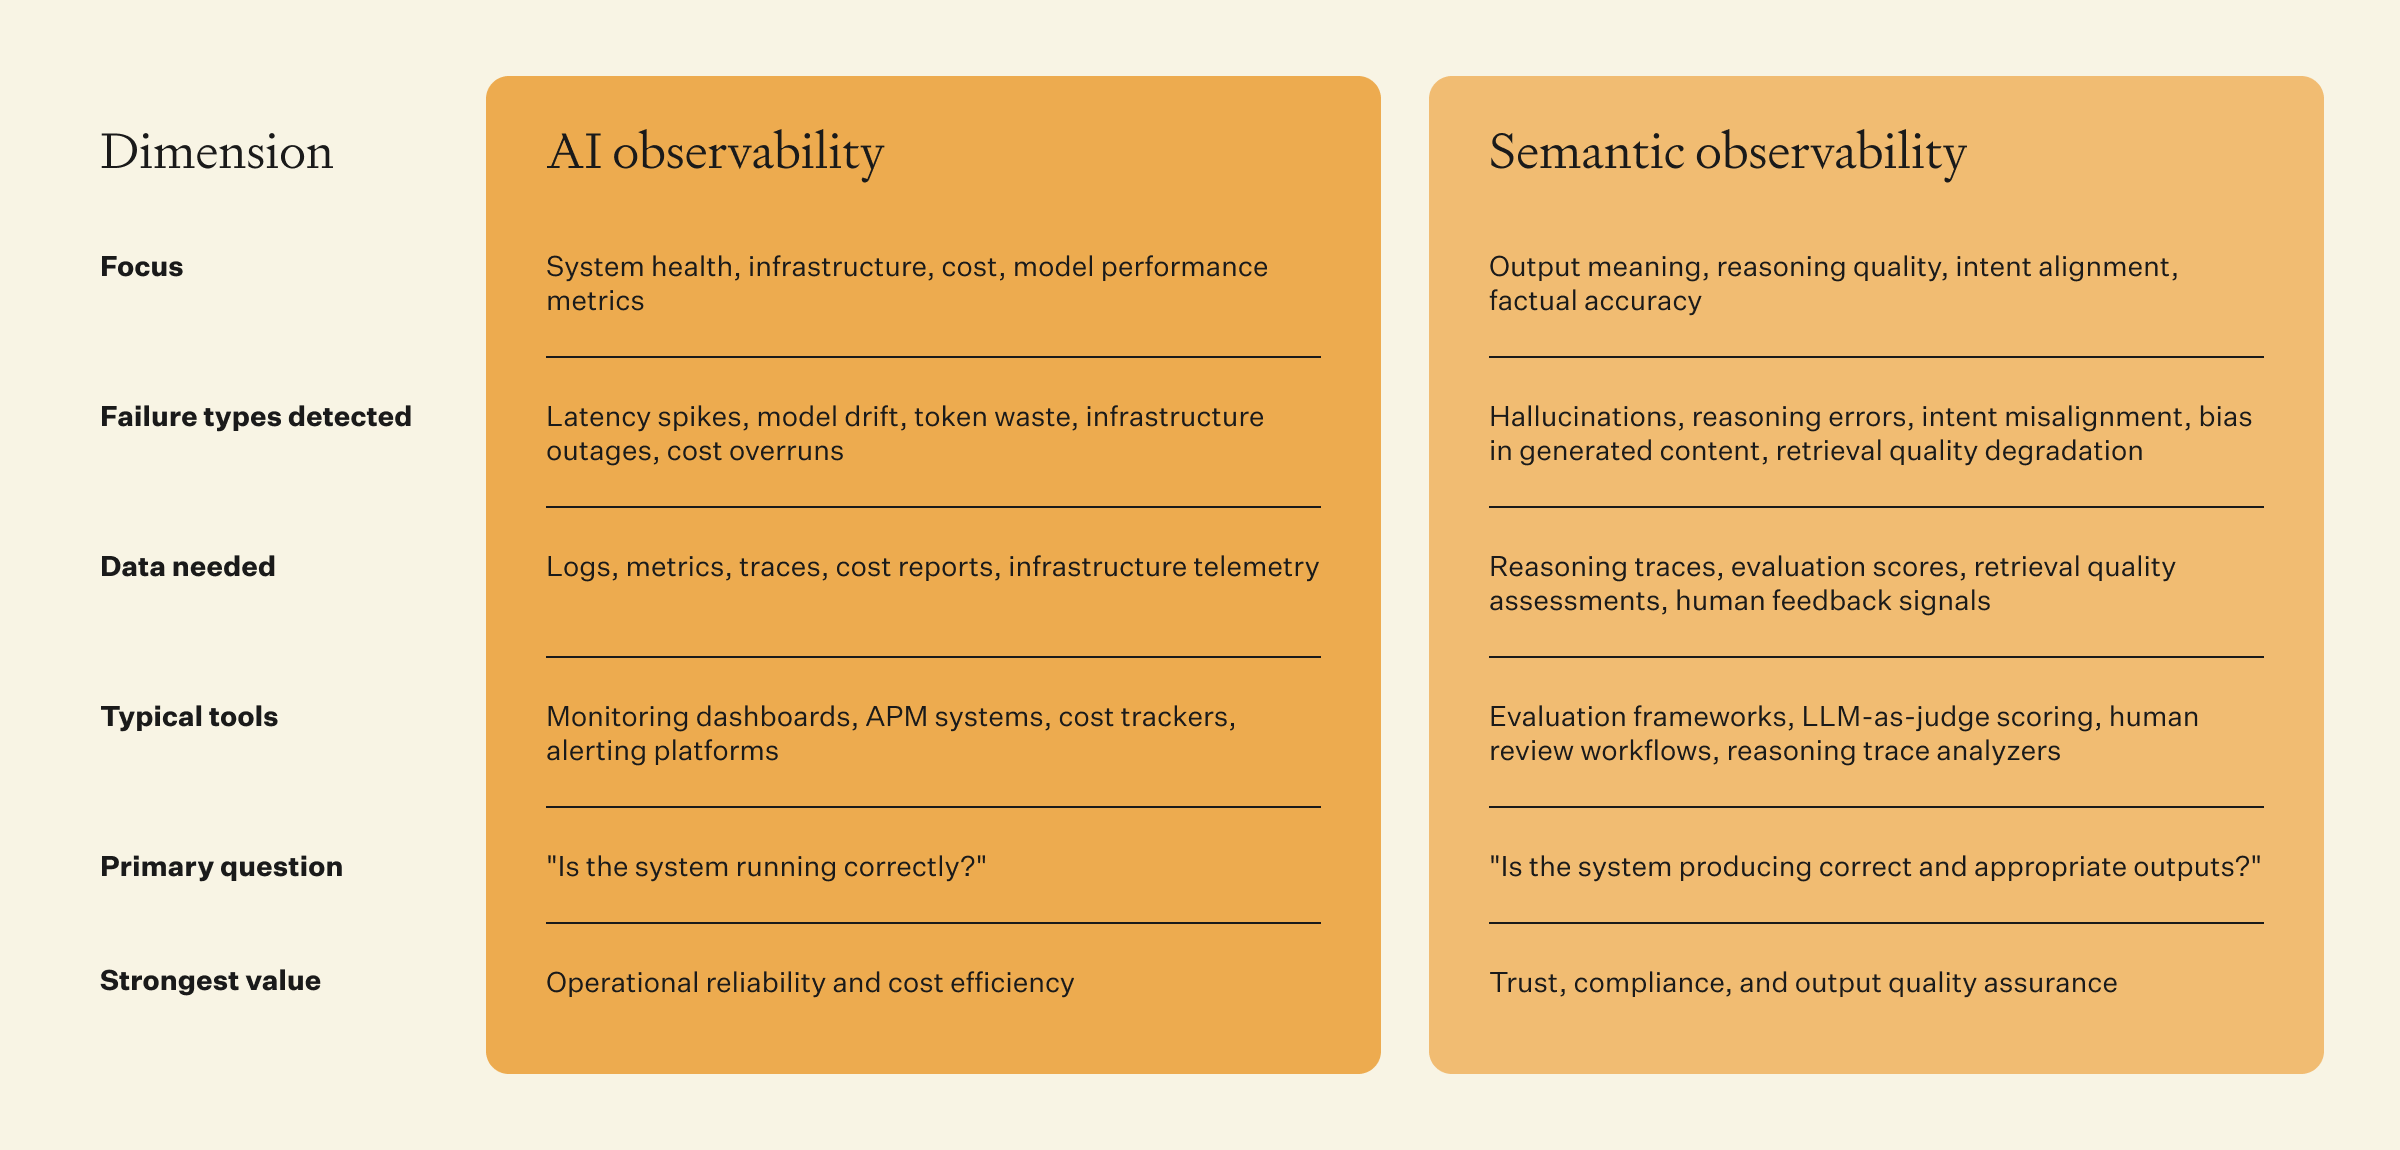
画像をクリックするとPDFで拡大表示できます
この比較から得られる重要なポイントは3つあります。
セマンティックオブザーバビリティーは、AIオブザーバビリティーを置き換えるのではなく拡張するものです。つまり、セマンティックな評価が価値を発揮するには、まずシステムが運用面で健全でなければなりません。インフラレベルのエラー率が30%もあるシステムで出力の品質を監視するのは、解決すべき問題の順番を間違えています。
各レイヤーが捉える障害モードは補完的です。AIオブザーバビリティーは、システムが応答できなくなる障害を捉えます。セマンティックオブザーバビリティーは、応答すべきでないときに応答してしまう障害や、誤って応答してしまう障害を捉えます。
本番環境で使える生成AIには、その両方が必要です。高速で、低コストで、信頼性が高くても、ハルシネーションを含む出力を生み出すAIシステムは本番環境に対応できているとは言えません。優れた出力を生み出しても、予算の3倍のコストがかかり、負荷がかかるとクラッシュするAIシステムも、やはり本番環境に対応できているとは言えません。
初期のプロトタイプでは、AIオブザーバビリティーだけを使います。出力が顧客に届くようになったり、規制対象の意思決定に使われるようになったりしたら、両方を使います。そして、人間がループに入らずに行動する自律型エージェントでは、セマンティックなチェックを最も重視します。
以下の判断マトリクスは、導入の状況ごとに適したオブザーバビリティーのアプローチを示したものです。
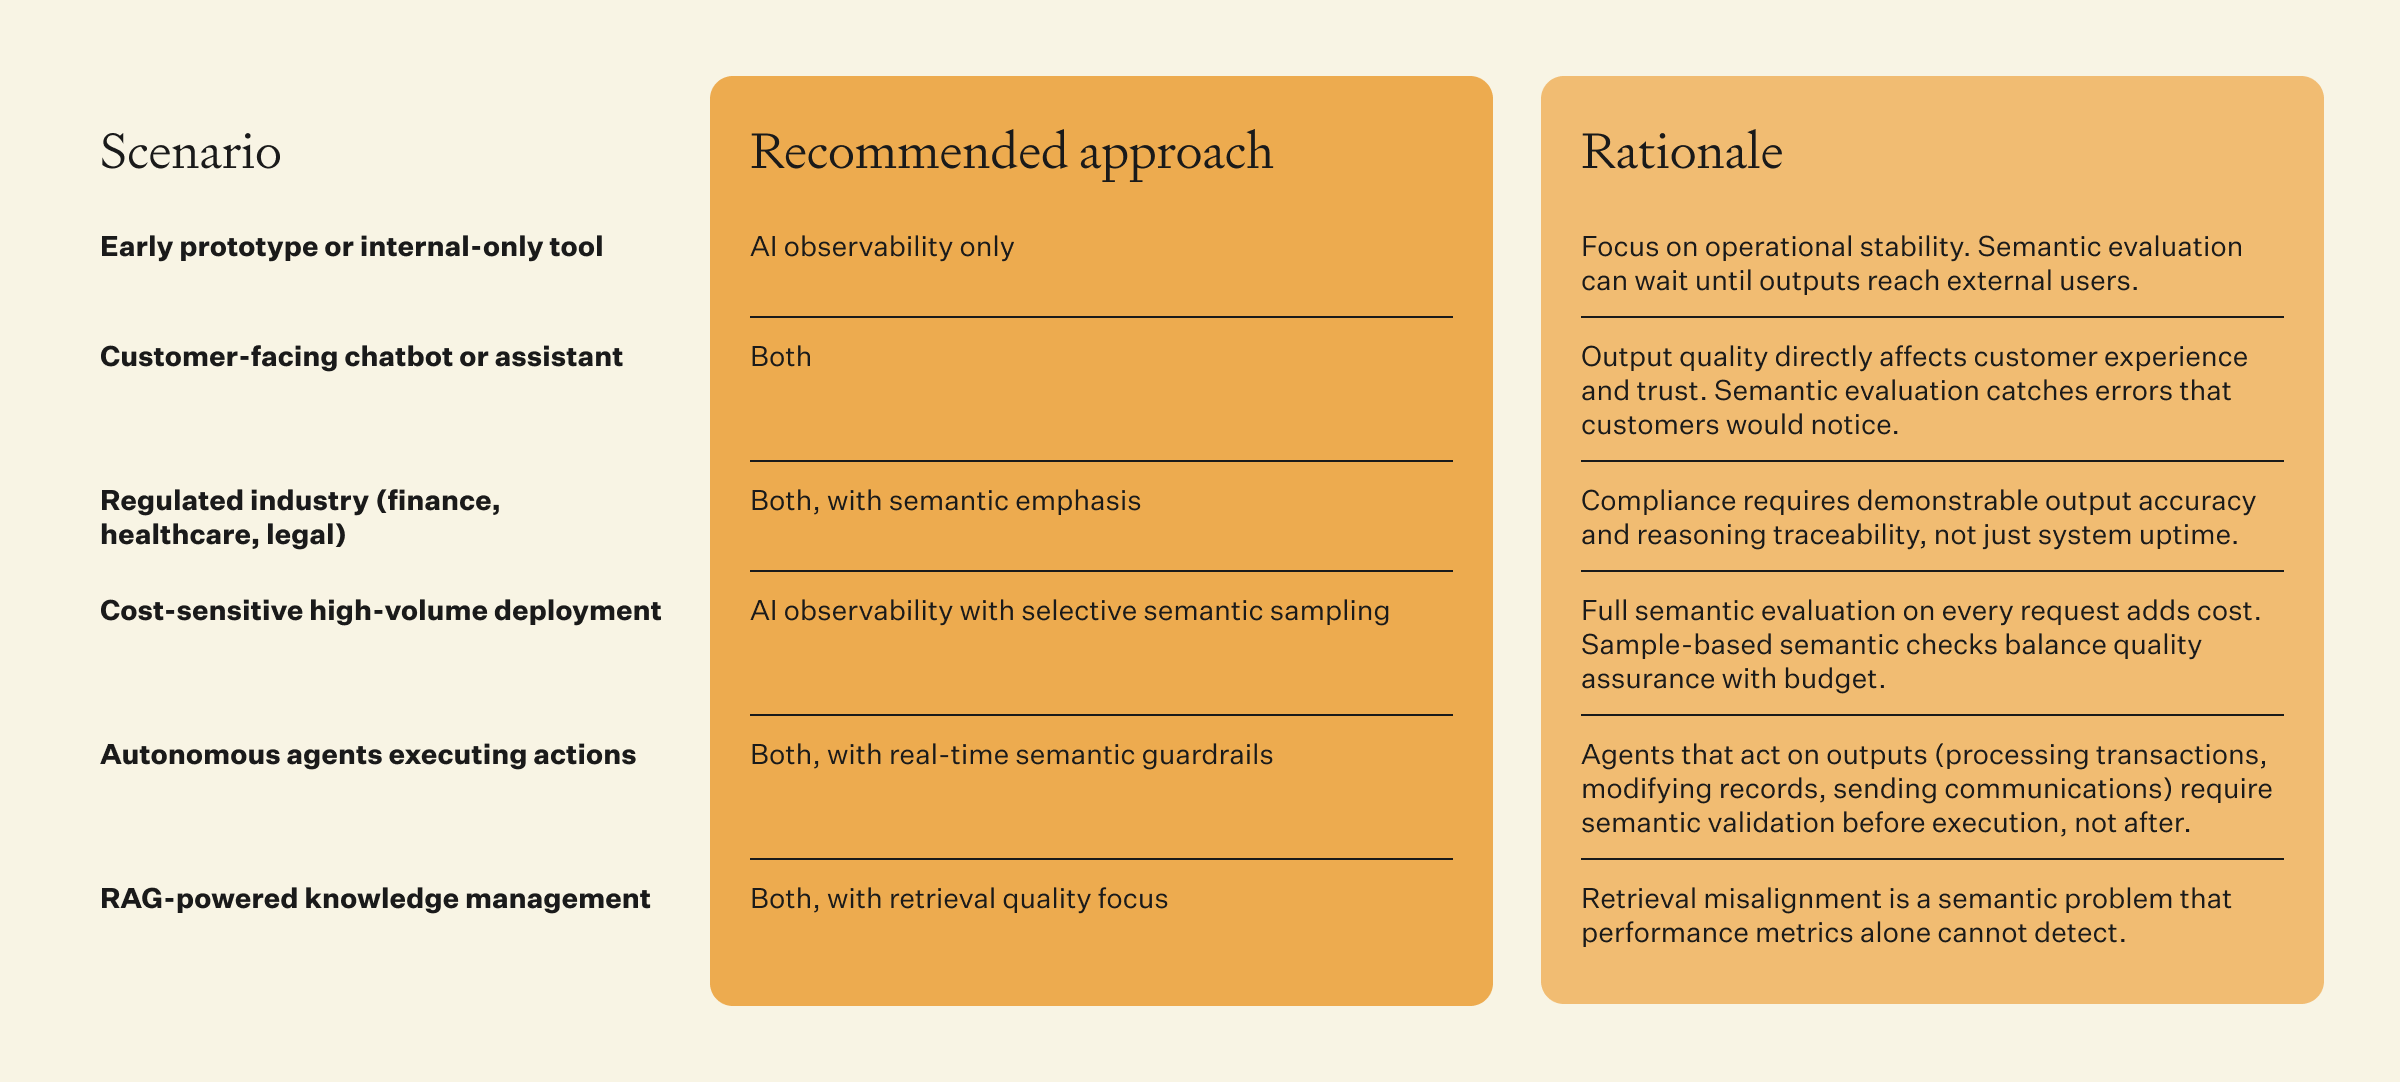
画像をクリックするとPDFで拡大表示できます
ゼロから始めるチームは、まずAIオブザーバビリティーの基盤(テレメトリ、ログ記録、コスト追跡、基本的なアラート)を構築し、次のいずれかの条件に当てはまるようになったら、セマンティックオブザーバビリティーを重ねていきましょう。
出力がエンドユーザーに直接届く。
出力が規制対象の意思決定に使われる。
エージェントが出力に基づいて自律的に行動する。
検索の品質が回答の正確性に直接影響する。
ハイブリッド型のツールも増えています。インフラの監視と評価フレームワーク、ガードレールを組み合わせたプラットフォームを使えば、AIオブザーバビリティーとセマンティックオブザーバビリティーを別々のスタックで運用する際の統合の負担を減らせます。
以下の5つのステップからなるチェックリストは、基盤となるテレメトリから継続的なガバナンスまで、導入の順序を示したものです。
すべてのLLM呼び出しに構造化されたログ記録を計装します。入力プロンプト、出力された応答、モデルのバージョン、トークン数(入力と出力)、レイテンシー、コストです。これは、AIオブザーバビリティーとセマンティックオブザーバビリティーの両方が依存する生データのレイヤーです。これがなければ、どちらのレイヤーも機能しません。
モデルの出力に対して、自動化された品質チェックを実装します。事実の正確性のスコアリング(LLM-as-a-judgeまたは参照ベースの評価)、意図との整合性チェック、安全性のスクリーニング(コンテンツポリシーへの準拠)、出力フォーマットの検証です。重要度の高いワークフローでは、セマンティックな検証に合格するまで、出力がユーザーに届いたりアクションを起動したりしないようブロックする、実行前のガードレールを追加しましょう。
推論トレース(入力から検索、生成を経て出力に至るまでの一連の流れ)を、検索可能なストアに保存します。出力が誤っているとフラグが立てられたとき、トレースは、障害が検索、推論、生成のどこで起きたのかを診断するためのフォレンジック証拠となります。
自動チェックには合格したものの意味的に誤っている出力を、人間のレビュー担当者やエンドユーザーが指摘できるチャネルを構築します。指摘された出力は評価キューにルーティングします。フィードバックデータを活用して、評価基準を改善し、ガードレールを更新し、体系的な障害パターンを特定します。
テレメトリ、評価、フィードバックのデータからコンプライアンスレポートを作成します。監査証跡が、適用される法域の規制要件を満たしていることを確認します。システムのユースケース、データソース、モデルのバージョンの変化にあわせて、評価基準を四半期ごとに見直し、更新しましょう。
レイテンシーとコストに関する注意点:すべてのリクエストに完全なセマンティック評価を行うと、処理時間(評価のスコアリング)とコスト(LLM-as-a-judgeのパターンでの追加のLLM呼び出し)が増えます。処理量の多いシステムでは、段階的な評価を導入しましょう。代表的なサンプルには完全なセマンティック評価を、すべてのリクエストには軽量なチェックを行い、異常検知で潜在的な問題が検出された場合には自動的に完全な評価を実行します。
AI Successのためのプラットフォームを提供するDataikuの一部であるDataiku LLMメッシュは、ルーティングレイヤーに監視、コスト管理、ガバナンスを組み込んだうえで、あらゆるモデルプロバイダーに接続し、AIオブザーバビリティーの基盤を提供します。LLM Meshは推論時にガバナンスの管理策を適用し、プロンプトと応答が本番環境に届く前にスクリーニングします。
AIオブザーバビリティーは、パフォーマンスとインフラを担い、システムが稼働しているか、十分に速いか、予算内に収まっているかに答えます。セマンティックオブザーバビリティーは、その上に推論の可視性を加え、出力が正確か、意図に沿っているか、説明責任を果たせるだけの追跡可能性があるかに答えます。
どちらのレイヤーも、単独では本番環境への対応を実現できません。段階的なアプローチが最も効果的です。まずAIオブザーバビリティーの基盤(テレメトリ、コスト追跡、アラート)から始め、出力がユーザー、ビジネス上の意思決定、規制対象のワークフローに影響する領域で、セマンティックなチェック(評価スコアリング、推論トレース、人間によるフィードバック)を重ねていきましょう。
Dataikuは、モデルとエージェント全体にわたるガバナンスによって両方のレイヤーを統合し、AIシステムが生み出す内容を、システムのパフォーマンスと同じくらい厳密に監視できるようにします。
モデルがハルシネーションを起こしても、レイテンシーやエラー率といったシステム指標は正常なままなので、AIオブザーバビリティーだけではハルシネーションを検知できません。セマンティックオブザーバビリティーは、評価ループ、推論トレースの分析、人間によるフィードバックを通じてそれを捉えます。重要度の高い生成AIシステムにとって、セマンティックオブザーバビリティは欠かせない検知レイヤーです。
AIの出力が重大な意思決定を左右する業界、つまり金融サービス、ヘルスケア、法務、カスタマーサービスで最も大きなメリットが得られます。いずれの業界でも、運用面では健全でも意味的に誤った出力を生み出すシステムは、AIオブザーバビリティーだけでは防げない法的責任を生む可能性があります。
まずはAIオブザーバビリティー(テレメトリ、コスト追跡、運用上のアラート)を基盤として整えましょう。出力がエンドユーザーに届く、規制対象の意思決定に使われる、あるいは自律的なアクションを起動するようになったら、セマンティックオブザーバビリティーを重ねます。この段階的なアプローチにより、本番環境が顧客に影響を与える前に、両方のレイヤーを準備しておくことができます。
AIオブザーバビリティーのコストは、主にインフラ(ログの保存、ダッシュボード、アラート)です。セマンティックオブザーバビリティーでは、評価のためのコンピューティング(LLM-as-a-judgeの呼び出し、トレースの保存、人によるレビュー)が加わります。すべてのリクエストを完全に評価すると実際にコストが増えるため、段階的な評価によって品質と予算のバランスをとりましょう。
この2つはスケールの仕方が異なります。AIオブザーバビリティーは、インフラに応じてスケールします。モデル、エンドポイント、指標が増えていきます。セマンティックオブザーバビリティーは、やり取りの複雑さに応じてスケールします。エージェントが増えるほど、意味がドリフトしうる受け渡しのポイントも増えていきます。最終的な出力だけでなく、それぞれの受け渡しをチェックしましょう。
Tags