AIエージェントによるサプライヤーリスク評価の全て
September 25, 2025/9分で読了/Christine Andrews, Romain Menini
過去数十年の間に、サプライチェーンはよりグローバル化し、多様化し、複雑化してきました。近隣国への移管や国内回帰といった取り組みが進められていても、その複雑性は依然として残り、混乱のリスクは依然として付きまといます。
サプライチェーンリーダーは、この複雑さを乗り越え、一部のリスクを管理するために、サプライチェーン管理戦略を進化させてきました。その進化が最も顕著に現れているのが、サプライヤー管理の領域です。サプライチェーンにおける重要な要素であるサプライヤー管理は、サプライヤーとの関係をより良く管理する能力と、サプライヤーリスクを軽減する調達戦略の改善という両面を包含します。つまり、サプライチェーンリーダーには、現在のサプライヤーポートフォリオを的確に把握し、サプライヤーリスクを評価、軽減するための革新的な戦略が求められているのです。
このようなインサイトを得るために、組織は多種多様な情報源からデータを収集、処理する能力を向上させる必要があります。しかし、アナリストの時間の60~70%(英語)がデータ収集に費やされている現状では、既に膨大な業務負荷にさらにデータ項目を追加するのは現実的ではありません。このことが、サプライチェーンリーダーがAIに注目する理由の一つとなっています。
優良なサプライヤーとは何か、リスクとなるサプライヤーとは何か――一見簡単に見えるこれらの問いには、さまざまな答えと示唆があります。
優良性は、納期遵守、契約順守、対応の速さ、好条件の価格設定などで測られます。一部の顧客は、サプライヤーパフォーマンスを定義するために数百ものパラメーターを取り入れており、二分的な分類は困難で、しばしば部門間の優先順位の衝突に左右されます。こうした課題に対してAIは、納期、品質、コンプライアンスなどの観点から最近の傾向とパフォーマンスを含む多様な属性に基づき、サプライヤーパフォーマンスを客観的にスコアリングする手段を提供することで、サプライヤー管理を支援します。AIがサプライヤーリスクの管理を支援するもう一つの方法は、位置情報、関連ニュース、気象イベント、その他公開情報などに基づいて新たなリスクを明らかにすることです。とくに生成AIは、社内外の多様な情報源にまたがるサプライヤー情報を要約するのに適しています。主要サプライヤーがニュースに取り上げられているタイミングや理由を把握することで、代替策やバックアップの必要性をより早く特定するのに役立ちます。
AIが活用されている3つ目の方法は、サプライヤーネットワークの多様化を促進するために適切な代替サプライヤーを特定することです。それを担うのがAIエージェントです。とくにエージェント型AIは、調達に関するガイダンスや推奨を提供するのに非常に適しています。この技術により、単純な品目タイプやカテゴリに基づく一致を超えて、より詳細な要件や仕様を取り入れることができます。WebスクレイピングやAPIの活用を通じて、AIエージェントは複数の基準を考慮しながら新たなサプライヤー候補を特定し、購買アナリストやバイヤーの調査を強力に支援します。
自動車業界のある製造企業は、主要サプライヤーの所在地に関連する地域ニュースやイベントなど、さまざまなデータソースや基準を用いてサプライヤーリスクを可視化しています。
外部プロバイダーから取得した市場データ、Webスクレイピングで収集したサプライヤー情報、そして過去のサプライヤーパフォーマンスに関する社内記録からのコンプライアンス情報を組み合わせることで、サプライチェーン内のさまざまな階層にわたるリスクを特定しています。こうした分析により、この自動車OEMはより信頼性の高い生産スケジュールを立てることができ、サプライヤーの遅延によって発生する1分あたり5,000ドルのダウンタイムコストを回避できます。部品不足による生産損失を最小限に抑えることで、30万ドル以上のコスト削減を見込んでいます。
別の事例では、航空宇宙業界のTier 1サプライヤーが、AIと機械学習技術を組み合わせて部品のトレーサビリティを検証し、不正のリスクを低減しました。原産国などの主要項目を含む提出内容の不整合や不正確さを検出するために、何百万ものサプライヤー文書を処理しています。これにより、すべての部品が信頼できるトレーサビリティーを持つサプライヤーから供給されていることを、高速かつ自動的かつ正確に確認できます。AIの活用によってアナリストの生産性が向上し、より一貫した不正検出手段が得られます。
これらのAIの概念がどのように実用的なソリューションに結び付くかを示すため、具体的なユースケースである「Supplier Management Assistant」をご紹介します。この実践的なアプリケーションは、調達チームが直面する最も複雑な課題の1つ――断片的なデータソースを横断しながら、数百から数千のベンダー関係を管理しつつ、サプライヤーリスクを評価する――に対応するものです。
Supplier Management Assistantは、複数のデータソースを実行可能なインテリジェンスに統合することで、最新のAIプラットフォームが調達の意思決定をいかに変革できるかを示しています。ユニバーサルAIプラットフォームであるDataikuで構築されたこのアシスタントは、組織が高度で複数ステップの分析ワークフローを、広範なコーディングスキルなしで構築できるようにします。Dataikuのマルチエージェントアーキテクチャーにより、調達マネージャーは「最近の関税変更の影響を最も受けているサプライヤーは?」「当社の上位10社のサプライヤーの財務状況は?」といった自然言語でSupply Chain Risk Agentに質問し、ほぼリアルタイムで回答を得ることができます。
このアシスタントは、DataikuのAgent Connect内で統合された単一のエージェントとして稼働します。各リクエストは、非構造データソースの検索と構造化された調達データの照会という2つの専用機能にルーティングされ、統合された回答がチャットインターフェースに返されます。これにより、ユーザーとのやり取りをシンプルに保ちつつ、バックエンド側では明確な関心の分離が実現されます。
このサンプルプロジェクトでは、2種類のデータが使用されています。
非構造データ:サプライヤーの年次報告書および開示情報で、定性的な文脈を補完します。
構造化データ:定義されたスキーマ(サプライヤーID、部品番号、確定納期と実納期、単価、数量)を持つ発注データセットで、予測情報や関税表により補完されます。
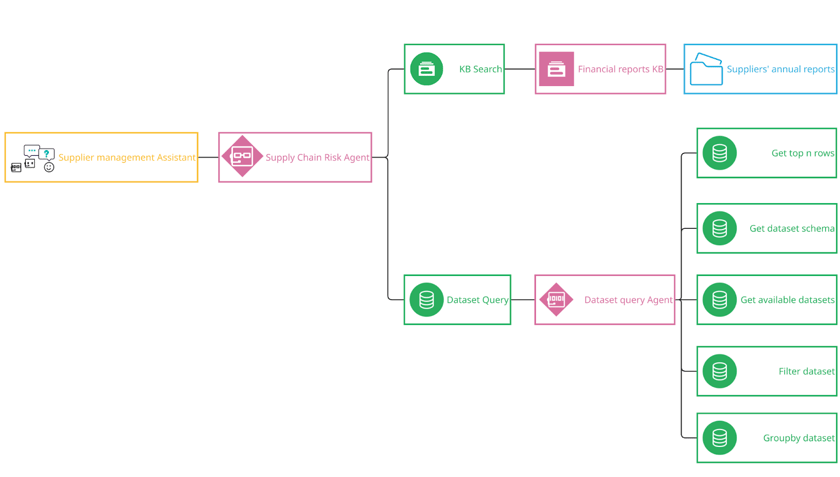
Agent Connect(オーケストレーション、上記図ではSupply Chain Risk Agentと表記):リクエストのライフサイクルを管理し、呼び出すべき機能を選択し、それらの出力を単一の応答に統合します。ユーザーの入り口であり、ガバナンスの管理ポイントでもあります。
Knowledge Bank Search(非構造データ対応):サプライヤーの財務報告書やコミュニケーション文書に対して検索補強型の検索を実行します。流動性リスク、再編活動、市場リスクなど、定性的なリスク要因を示す根拠のある記述を抽出します。
Dataset Query(構造化データ対応):自然言語のプロンプトを、調達データセットに対するクエリに変換します。対象は発注履歴(価格、数量、納品実績)、需要予測、国、製品別の関税データなどです。
デモ段階から本番運用へ移行するには、エージェントを明確なワークフロー、堅牢なデータ基盤、モジュール設計に基づいて強化する必要があります。以下のベストプラクティスは、信頼性とスケーラビリティーの確保に役立ちます。
1. 技術的に特化した高付加価値ユースケースを優先する
エージェントをまず最も重要な調達ワークフローに集中させ、それらを支えるアーキテクチャーを構築します。
Agent Connectで利用可能なツールは、ワークフローに必要なものに限定します(例:サプライヤーレポートに限定したKnowledge Bank Search、納品指標向けSQLテンプレートを活用するDataset Queryなど)。
配送実績、財務状況、関税シミュレーションといった特定の意図を、決定論的なツールのシーケンスにマッピングするルーティングルールや軽量な分類器を定義します。
構造化クエリで返すことができるKPI(平均遅延日数、納期遵守率、単価の推移など)をあらかじめ定義することで、厳格なスキーマ契約を徹底します。
埋め込み対象を、サプライヤーIDや報告期間でタグ付けされた、精選されたサプライヤーレポートに限定することで、ナレッジベースの集中度を維持します。
2. 厳格なデータ品質基準を徹底する
データ品質は、信頼できる検索と計算の基盤であり、上流のエラーはエージェントの出力に直接現れます。
ERP出力、予測、関税台帳において、一意かつ一貫したサプライヤーキーを維持し、結合エラーを防止します。
埋め込み前に、サプライヤー名、報告期間、形式などのタグ付けを行い、非構造データソースを正規化します。
品質チェックを自動化する:構造化テーブルのスキーマ検証、取引の重複検出、埋め込みデータに対するカバレッジレポートの作成など。
エージェントが常に最新で信頼できる情報に基づいて動作するよう、データのドリフトと更新スケジュールを監視します。
3. モジュール型の拡張性を前提に構築する
アーキテクチャーは安定性を保ちつつ、新たなデータソースやツールを段階的に統合できる設計にすべきです。
ナレッジバンク検索、データセットクエリ、予測モデル、関税表など、各機能はそれぞれ独立したライフサイクルを持つプラグイン型モジュールとして扱います。
新しいデータセットやナレッジソースが追加されても、オーケストレーションロジックは安定して機能するように設計します。
Dataikuのコード不要な環境では、大規模な再設計をせずとも、新しいモジュールの追加や既存モジュールの更新を視覚的インターフェースで行えます。これにより、エージェントの保守が容易になり、モジュール単位での進化が可能になり、複雑なリファクタリングなしでガバナンスも維持できます。
Tags