AIにおけるセマンティックドリフト:本番環境での検知、測定、防止の方法
September 17, 2026/7 min read/Team Dataiku
AIにおけるセマンティックドリフトとは、モデルの理解や出力が、時間の経過とともに本来意図された意味から徐々に離れていく現象です。システムが壊れたり、エラーを出したりするわけではありません。
1週目には請求に関する問い合わせを正確に解決していたカスタマーサポートエージェントが、4週目には製品の推奨へと話をそらし始める。モデル自体は変わっていません。マルチターンの文脈にノイズが蓄積し、会話が本来の意図から離れていったのです。
1月には「アクティブ顧客」の数が一致していた2つの部門のダッシュボードが、6月には15%の差を示すようになる。これも同様の理由によるものです。データは変わっていませんが、一方のチームのAIパイプラインはエンティティ解決のロジックを更新し、もう一方は更新しないままだったのです。
セマンティックドリフトを放置すると、精度が低下し、結果に一貫性がなくなり、AIによる意思決定への信頼が損なわれます。本ガイドでは、本番環境でセマンティックドリフトを特定、測定、防止する方法を解説します。
セマンティックドリフトは、精度の変化ではなく、意味の乖離です。モデルは高い精度スコアを維持したまま、その出力が本来の意味から徐々に逸脱していくことがあります。
セマンティックドリフトは、モデルドリフト、コンセプトドリフト、データドリフト、ハルシネーションとは異なります。それぞれが、AIシステムの挙動における異なる種類の変化を指しています。
エンタープライズ環境で最も頻繁に見られるのは、2つの現れ方です。マルチターンの会話におけるドリフト(長いセッションの中でエージェントが本来の意図を見失う)と、ビジネス指標のドリフト(共有された用語がチームによって異なる意味を持つ)です。
測定には、従来の精度指標ではなく、意味に特化したアプローチが必要です。埋め込み距離、セマンティック類似度スコアリング、含意チェック、LLM-as-a-judgeによる評価などです。
防止には、技術的な管理策(コンテキストのリフレッシュ、セマンティックレイヤー、回帰テスト)と、組織的なガバナンス(用語のオーナーシップ、用語集の管理、チーム間の整合)を組み合わせます。
セマンティックドリフトとは、AIシステムがコンテンツを解釈、生成する際の意味が、本来意図された意味から徐々に乖離していくことです。それは予測がどれだけ正しいかではなく、予測が何を意味しているかに現れます。
関連する他のドリフトとの違いが重要なのは、それぞれに異なる検知方法と異なる是正アプローチが必要になるからです。
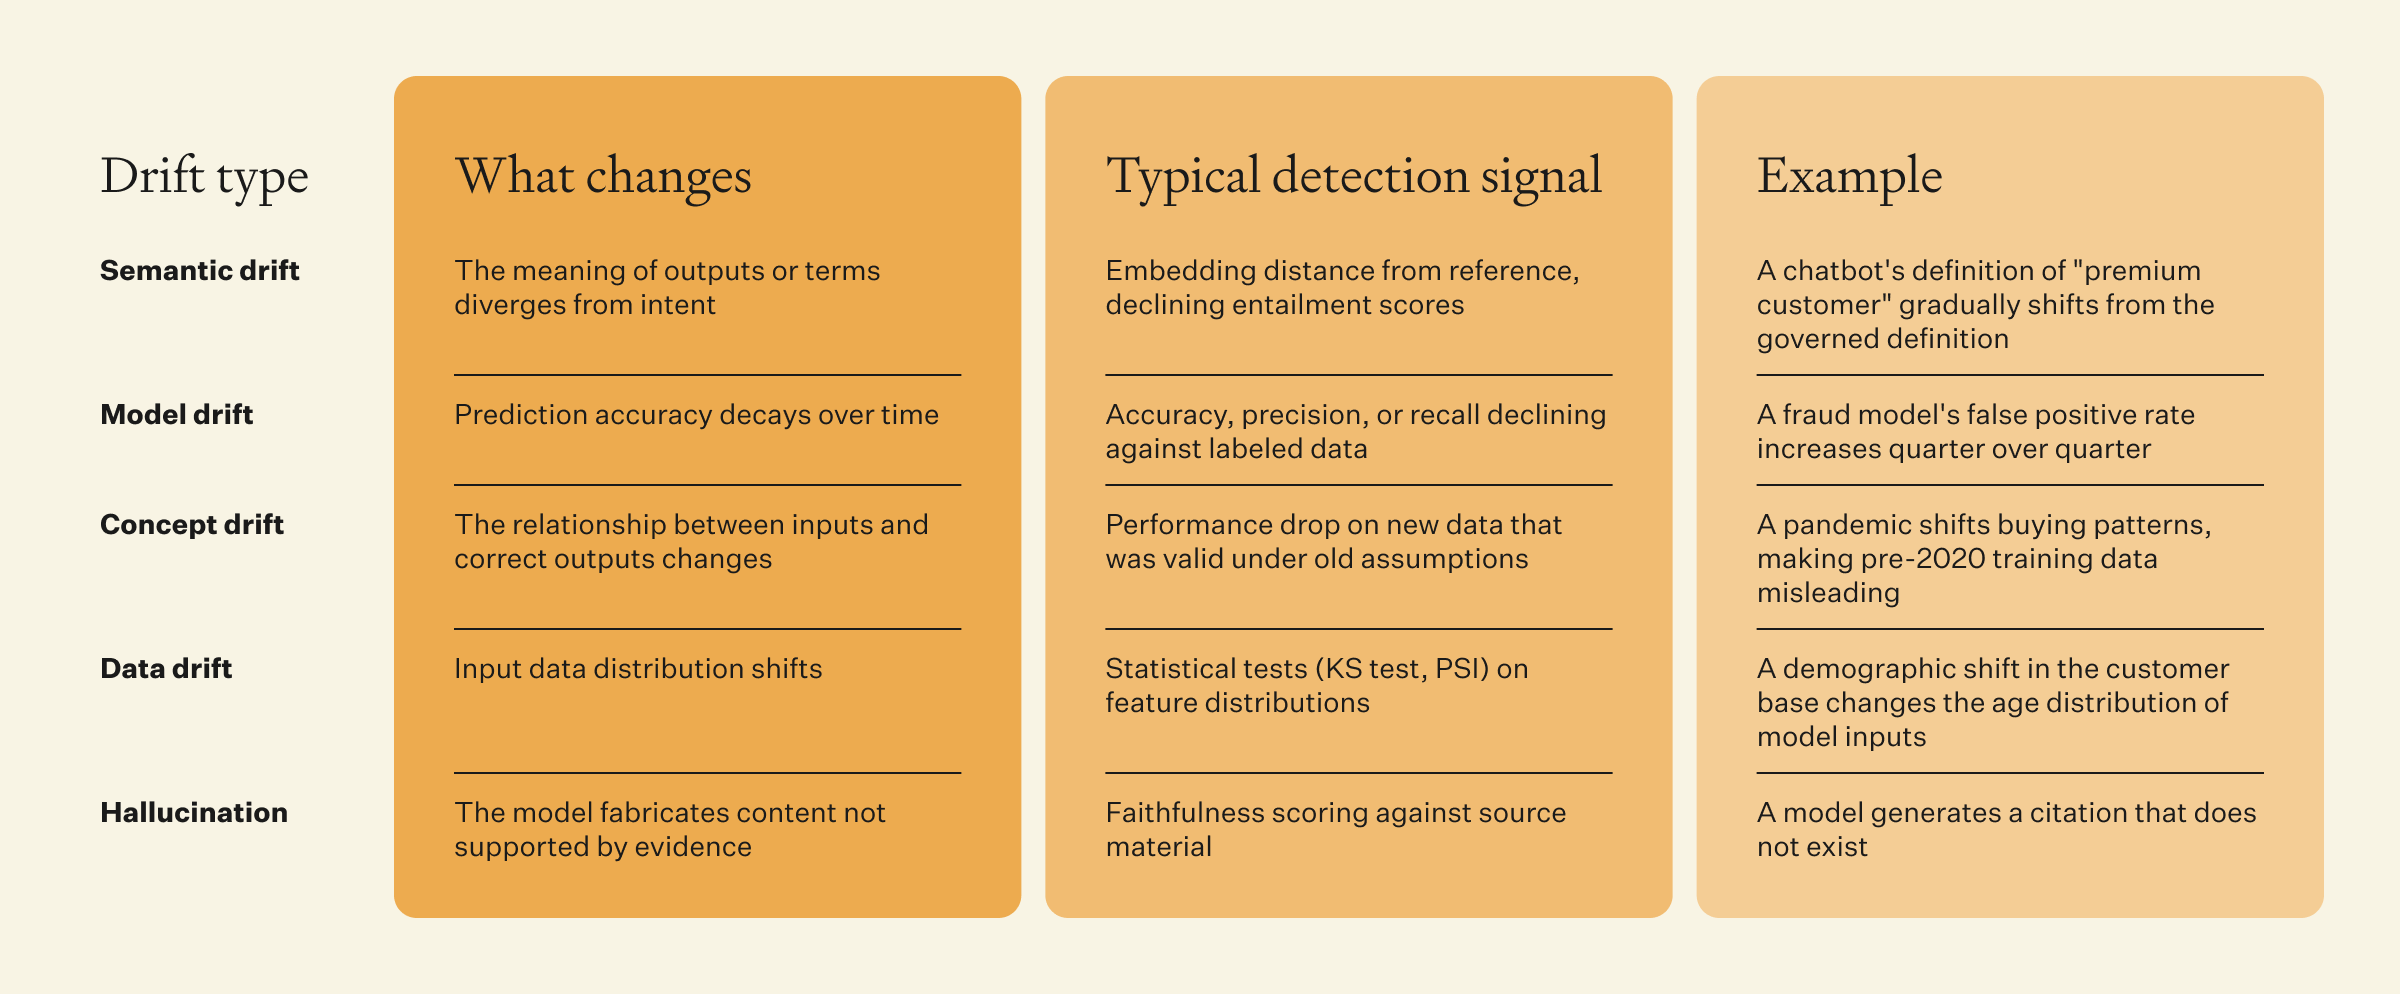
画像をクリックするとPDFで全体を表示できます
セマンティックドリフトが最も捉えにくい理由は、精度、データ分布、モデルのパフォーマンスがすべて安定しているように見える中でも起こりうるからです。ダッシュボードは、誤った定義を使って正しい数値を報告し、あらゆる技術的チェックに合格することがあります。エージェントは、ユーザーが尋ねていない質問に事実として正確な回答を返し、成功したやり取りとして記録することがあります。
この違いを理解するために、2つの具体例を見てみましょう。顧客のオンボーディングを担当するマルチターンのチャットボットは、セッションの開始時にはアカウント設定に集中しています。しかし8ターン目になると、蓄積された文脈によって会話は製品機能の話題へと移り、エージェントはオンボーディングのタスクを完了させるのではなく、機能に関する質問に答えるようになっています。エラーやハルシネーションではなく、会話の意味がドリフトしたのです。
また別の例として、2つのチームが「アクティブ顧客」の数を報告するダッシュボードを構築したとします。一方のチームのAIパイプラインは「30日以内にログインした顧客」をアクティブと定義し、もう一方は「90日以内に購入した顧客」と定義しています。どちらの定義も作成時には妥当でしたが、ビジネスが変化しても両チームとも定義を更新せず、数値は乖離していきます。これが、ビジネス指標レベルでのセマンティックドリフトです。
エンタープライズにおけるセマンティックドリフトのインシデントの大半は、2つの現れ方によるものです。
エージェントやコパイロットとの長いセッションでは、ユーザーの本来の意図がターンを重ねるごとに薄れていくことがあります。応答のたびに会話履歴に文脈が加わり、ターンが進むにつれて、蓄積された文脈がモデルの焦点を本来の依頼から、途中のやり取りで出てきた本筋から外れた話題へと移してしまうのです。
2025年の研究「LLMs Get Lost in Multi-Turn Conversation」(Laban et al.、Microsoft ResearchおよびSalesforce)では、主要なオープンウェイトモデルとクローズドウェイトモデル全体で、シングルターンからマルチターンの設定に移ると平均39%のパフォーマンス低下が見られました。その主な要因は、会話が長くなるにつれて信頼性が急激に低下することにあります。長いセッションで稼働するエージェントやコパイロット(カスタマーサポートのエスカレーション、複数ステップのリサーチワークフロー、共同でのドキュメント編集など)にとって、マルチターンのドリフトはたまに起きる失敗ではなく、体系的な信頼性のリスクです。
複数のAIシステム、ダッシュボード、チームが、微妙に異なる定義で同じ用語を使っていると、共有された指標の意味が気づかれないまま乖離していくことがあります。「売上」は、あるパイプラインでは総額を、別のパイプラインでは純額を意味します。「解約」は、あるモデルでは自主的な離脱を数え、別のモデルでは支払い不能による非自発的な離脱も含めます。
数値が間違っていることがリスクではありません。リスクは異なる意味を持つ数値に基づいて意思決定が行われ、取締役会への報告、規制当局への提出書類、照合作業などで不一致が表面化するまで、誰もそれに気づかないことです。
どちらの現れ方にも、具体的なビジネスリスクがあります。それは、不正確なデータではなく、ドリフトした意味に基づいて意思決定が行われることです。エージェントが誤ったタスクを完了したのは、ハルシネーションを起こしたからではなく、本来の意図を見失ったからです。経営陣が整合していない指標に基づいて行動したのは、データが誤っていたからではなく、定義が乖離していたからです。
セマンティックドリフトを測定するには、精度の維持ではなく、意味の維持を追跡するアプローチが必要です。従来の指標(精度、適合率、再現率)は、意味がドリフトしていても安定したままのことがあるからです。
現在の出力の埋め込みと、意図された意味を表す参照埋め込みとの間のコサイン距離を計算します。時間とともに距離が大きくなれば、ドリフトの兆候です。最も軽量な継続的監視の手法ですが、埋め込みの類似度では捉えられないビジネス用語の不整合は見逃してしまいます(2つの定義が、埋め込み空間では意味的に近くても、ビジネスの文脈では異なることを意味している場合があります)。
文埋め込みモデルを使用して、各出力が正しい意味を表す参照出力にどれだけ近いかをスコアリングします。スコアリングモデルはベクトルレベルだけに頼るのではなく、意味レベルで類似度を評価するため、単純な埋め込み距離よりも細かなニュアンスを捉えられます。
現在の出力が、参照となる意味を含意している(つまり論理的に導かれる)かを検証します。含意モデルは、出力が本来の意図を維持しているのか、それとも意図しない新たな意味を持ち込んでいるのかを評価します。各ターンが本来の依頼と一貫していなければならない、マルチターンの会話におけるドリフトの検知に特に有効です。
2つ目のモデルを使って、出力が意図された意味を維持しているかを評価します。ジャッジ役のモデルは、本来の意図(参照プロンプトまたは定義)、現在の出力、採点基準を受け取り、定められた尺度で意味の維持を評価します。最も忠実度の高い手法ですが、評価1回あたりのコストも最も高くなります。
セマンティックドリフト評価パイプラインの導入チェックリスト:
監視対象の各ユースケースについて、参照となる意図または定義を定める。
コストと忠実度の要件に基づいて、測定手法を選択する。
出力を参照となる意図とあわせて取得できるよう、パイプラインを計装する。
定められた頻度でドリフトスコアを算出する(埋め込み距離は継続的に、LLM-as-a-judgeは日次バッチで)。
アラートのしきい値を設定する(ベースラインからの偏差10%で警告、20%で重大)。
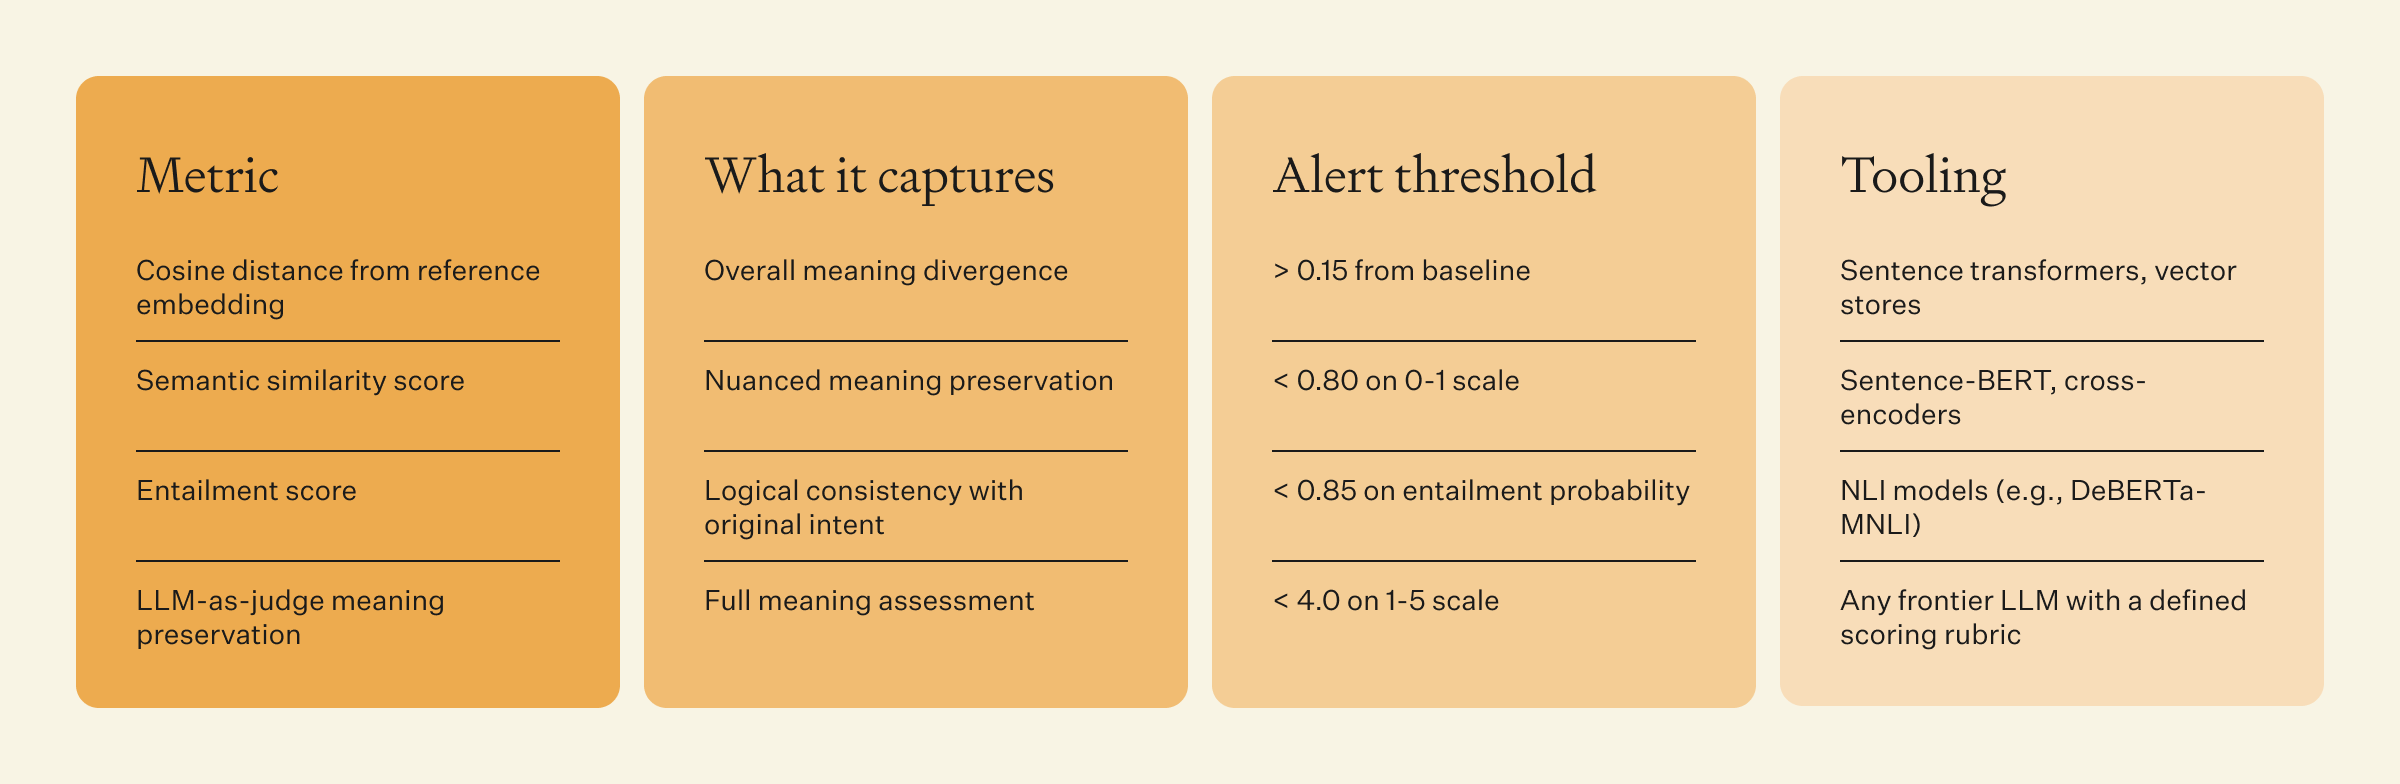
画像をクリックするとPDFで全体を表示できます
注意:埋め込み距離のスコア1つだけに頼らないでください。埋め込み距離はベクトルレベルの乖離は捉えられますが、2つの定義が埋め込み空間では意味的に近い(「ログインしたアクティブ顧客」と「購入したアクティブ顧客」など)一方で、ビジネスの文脈では実質的に異なることを意味しているような、ビジネス用語の不整合を見逃すことがあります。確実に検知するには、複数の手法を組み合わせましょう。
エンタープライズのAIシステムでセマンティックドリフトを引き起こす根本原因は4つあります。それぞれが、特定の測定方法と防止策に対応しています。
長い会話では、途中の文脈が蓄積するにつれて、本来の指示が薄れていきます。10ターン目になると、モデルの挙動に対するシステムプロンプトの影響は、蓄積された会話履歴に比べてわずかなものになっている可能性があります。エージェントはもはや本来の指示に従っておらず、会話の流れに引きずられているのです。
検知:各ターンで、元のシステムプロンプトに対する含意スコアを算出する
防止:本来の意図を再注入するコンテキストリフレッシュのパターン
ビジネス用語の意味は、時間とともに変わります。「プレミアム顧客」は、昨年は「年間支出10万ドル以上」を意味していたものが、今年は「エンタープライズ契約があり年間支出5万ドル以上」を意味しているかもしれません。AIシステムの定義が更新されなければ、システムはもはやビジネスの実態を反映していない意味に基づいて動き続けることになります。
検知:認定済みエンティティレジストリに対するガバナンス適合スコア
防止:バージョン管理された定義を持つセマンティックレイヤー
RAGパイプラインに供給されるドキュメントコーパスが拡大し、変化し、古くなるにつれて、モデルが依拠するグラウンディングの文脈も変化します。新しいドキュメントでは異なる用語が使われているかもしれません。古いドキュメントには、時代遅れの定義が含まれているかもしれません。モデルの回答がドリフトするのは、その情報源がドリフトしたからです。
検知:検索の関連性スコアの経時的な追跡
防止:鮮度チェックと非推奨ドキュメントの削除を含む、ドキュメントのライフサイクル管理
業界用語、製品名、規制上の文言は変化していきます。2024年のテキストで学習した静的な埋め込みモデルでは、2026年の用語を正確に表現できない可能性があります。2024年当時のクエリと2026年のドキュメントとのコサイン類似度が想定より低くなり、検索漏れや意味的な関連性の低下を招くことがあります。
検知:更新されたテストセットに対する定期的なベンチマーク評価
防止:埋め込みモデルの定期的な更新とインデックスのリフレッシュ
防止策は3つのレベルで機能します。会話のドリフトに対するセッションレベルの管理策、ビジネス指標のドリフトに対する組織レベルの管理策、検索のドリフトに対するパイプラインレベルの管理策です。
(ドリフトが蓄積する)会話履歴全体に頼るのではなく、本来の意図を定期的に文脈へ再注入します。これにより、モデルの焦点が本来のタスクにリセットされます。
def build_refreshed_context(original_intent: str, recent_turns: list, max_turns: int = 3):
"""Re-inject original intent alongside recent context to prevent drift."""
refresh_prompt = f"Original request: {original_intent}\n\n"
refresh_prompt += "Recent conversation:\n"
for turn in recent_turns[-max_turns:]:
refresh_prompt += f"- {turn}\n"
refresh_prompt += "\nContinue addressing the original request above."
return refresh_prompt頻度:顧客対応のエージェントでは3~5ターンごとにリフレッシュします。複数ステップのワークフローでは、新しいサブタスクを開始するたびにリフレッシュします。
セマンティックレイヤーは、各ビジネス用語に対してガバナンスされた1つの定義を提供し、その用語を使用するすべてのAIシステムに適用します。「アクティブ顧客」の定義が変わると、その変更はバージョン管理、文書化され、その用語を参照するすべてのパイプラインに反映されます。これにより、チーム間で指標の不整合を引き起こす定義のドリフトを防ぎます。
頻度:部門横断の関係者(データエンジニアリング、ビジネス、コンプライアンス)による四半期ごとのオントロジーレビュー。
意図された意味を表す参照回答を持つクエリのテストセットを構築します。定期的にこのテストセットを本番システムに対して実行し、参照回答とのセマンティック類似度をスコアリングします。類似度スコアの低下は、ドリフトがユーザーに届く前のシグナルとなります。
頻度:毎週の自動回帰テスト実行。回帰テスト結果の月次レビューとしきい値の調整。
再トレーニングやファインチューニングだけでは解決しません。セマンティックドリフトは精度の問題ではなく、意味の問題です。再トレーニングしたモデルは、ビジネス用語の誤った定義を使ったまま、より高い精度スコアを達成することがあります。再トレーニングで解決できるのはモデルドリフトです。学習データそのものが現在意図されている意味を反映するよう更新されない限り、セマンティックドリフトは解決しません。
AI Successのためのプラットフォームを提供するDataikuは、アナリティクス、モデル、エージェントを構築、デプロイ、ガバナンスするためのエンタープライズオーケストレーションレイヤーです。Dataiku LLM Guard Services(Safe Guard、Cost Guard、Quality Guard)は、推論時に組み込みのチェックを提供します。特にQuality Guardは、出力が本番環境に届く前に意味と品質の側面を評価し、事後的な監視だけに頼るのではなく、生成の時点でセマンティックドリフトを捉えます。
セマンティックドリフトは技術的な問題であると同時に、定義とオーナーシップの問題でもあります。技術的な監視が捉えられるのは症状だけで、原因を防ぐのはガバナンスだからです。以下のチェックリストは、技術的な監視を効果的に機能させるための組織的な管理策をまとめたものです。
用語のオーナーを割り当てる。
ガバナンス対象のすべてのビジネス用語に、定義の正確性と最新性に責任を持つオーナーを文書化して割り当てます。オーナーは、その用語を実装したデータエンジニアではなく、用語の意味を定義するビジネス側の関係者です。
バージョン管理された用語集を維持する。
AIシステムで使用されるすべてのビジネス用語について、一元化されバージョン管理された用語集に正規の定義を設けます。定義の変更は、レビューと承認のワークフローに従います。
定義の変更に承認を必須とする。
用語の定義を変更する際は、用語オーナーの承認を得たうえで、その用語を参照するAIシステムを持つすべてのチームに通知します。
埋め込みドリフトのアラートを設定する。
監視対象のすべてのユースケースについて、参照埋め込みからのコサイン距離にしきい値ベースのアラートを設定します。アラートは用語オーナーとAIチームにルーティングします。
セマンティックレイヤーの変更を記録する。
セマンティックレイヤーの定義に対するすべての変更(エンティティのマッピング、計算ロジック、リレーションシップの更新)を、変更不可能な監査証跡に記録します。
ロールバック手順を定める。
定義の変更が下流で予期しない影響を引き起こした場合に、本番システムを中断することなく以前の定義に戻せるようにします。
部門横断の整合レビューを定期的に実施する。
データエンジニアリング、ビジネス、コンプライアンスの各チームが、ガバナンスされた定義が今もビジネスの実態を反映しているかを四半期ごとに確認します。
マルチターンのセッションの長さと意図の維持を監視する。
会話型エージェントについて、セッションが長くなるにつれて意図との整合性がどのように低下するかを追跡します。観測されたドリフトのパターンに基づいて、セッションの最大長やコンテキストリフレッシュの必須化を設定します。
検索コーパスの鮮度を監査する。
RAGシステムでは、ドキュメントコーパスが最新であり、非推奨のドキュメントが削除されていることを確認します。古くなった検索コーパスは、RAGを活用したアプリケーションにおける意味のドリフトの最も一般的な原因です。
ドリフト指標をビジネスKPIとあわせて報告する。
セマンティックドリフトの指標をビジネスパフォーマンスと同じガバナンスレビューで報告すると、意味の維持とビジネス成果の質との相関が可視化され、対応につなげやすくなります。
Dataiku Governは、用語のオーナーシップ、承認ワークフロー、監査証跡を一元化し、セマンティックドリフトを防ぐ組織的なガバナンスと、それを検知する技術的な監視とを結びつけます。
セマンティックドリフトの現れ方は、ドリフトの原因が会話(ターンを重ねるごとに文脈にノイズが蓄積する)なのか、組織(定義がチームごとに独自に変化する)なのかによって異なります。ここでは、よく見られる2つのパターンを紹介します。各事例には、ドリフトを捉えた検知方法と、それを解決した防止策が含まれています。
以下は、よく見られるセマンティックドリフトのパターンに基づく代表的なシナリオです。詳細は説明のためのものです。
ある企業のITヘルプデスクエージェントは、Slack上の長い会話を通じてサポートチケットに対応しています。エージェントは各セッションの開始時には、ユーザーが報告した問題に集中しています。しかし、確認のためのやり取りが5~7ターン続くと、エージェントは本来の問題ではなく、途中のメッセージで言及された症状に対応し始めます。ユーザーからは、エージェントが「何を聞いたのか忘れてしまう」ため、問題を説明し直さなければならないという声が上がっていました。
検知:元のチケットの説明に対する含意スコアが、7ターン目までに0.92から0.61へと一貫して低下していました。
適用した防止策:4ターンごとに元のチケットの説明を再提示するコンテキストリフレッシュプロンプトを注入しました。含意スコアは0.85以上で安定し、セッションの完了率は23%向上しました。
ある小売企業のマーケティングチームと財務チームは、どちらも経営陣向けダッシュボードで「顧客生涯価値」(CLV)を報告していました。マーケティングはエンゲージメントスコアに基づく将来の予測価値を用いてCLVを算出し、財務は過去の取引データのみを用いてCLVを算出していました。どちらのダッシュボードにも「CLV」というラベルが付けられており、35%の差が見つかったのは取締役会の場でした。
検知:ガバナンス適合の監視により、マーケティングのCLVパイプラインがセマンティックレイヤーを経由せず、独自の計算を使用していたことが判明しました。CLVに関するクエリのガバナンス適合スコアは3か月で98%から71%に低下していましたが、しきい値が高すぎたためにアラートは発生していませんでした。
適用した防止策:セマンティックレイヤーを更新し、ガバナンスされた単一のCLVの定義を設けました。両方のパイプラインをその定義を参照するよう再設定し、ガバナンス適合のしきい値を95%に引き下げてアラートを有効にしました。
以下のカテゴリでは、本ガイドで取り上げたツールを、それぞれが最も得意とする検知対象ごとに分類しています。チームは、監視したいドリフトの種類に合ったツールを選ぶことができます。
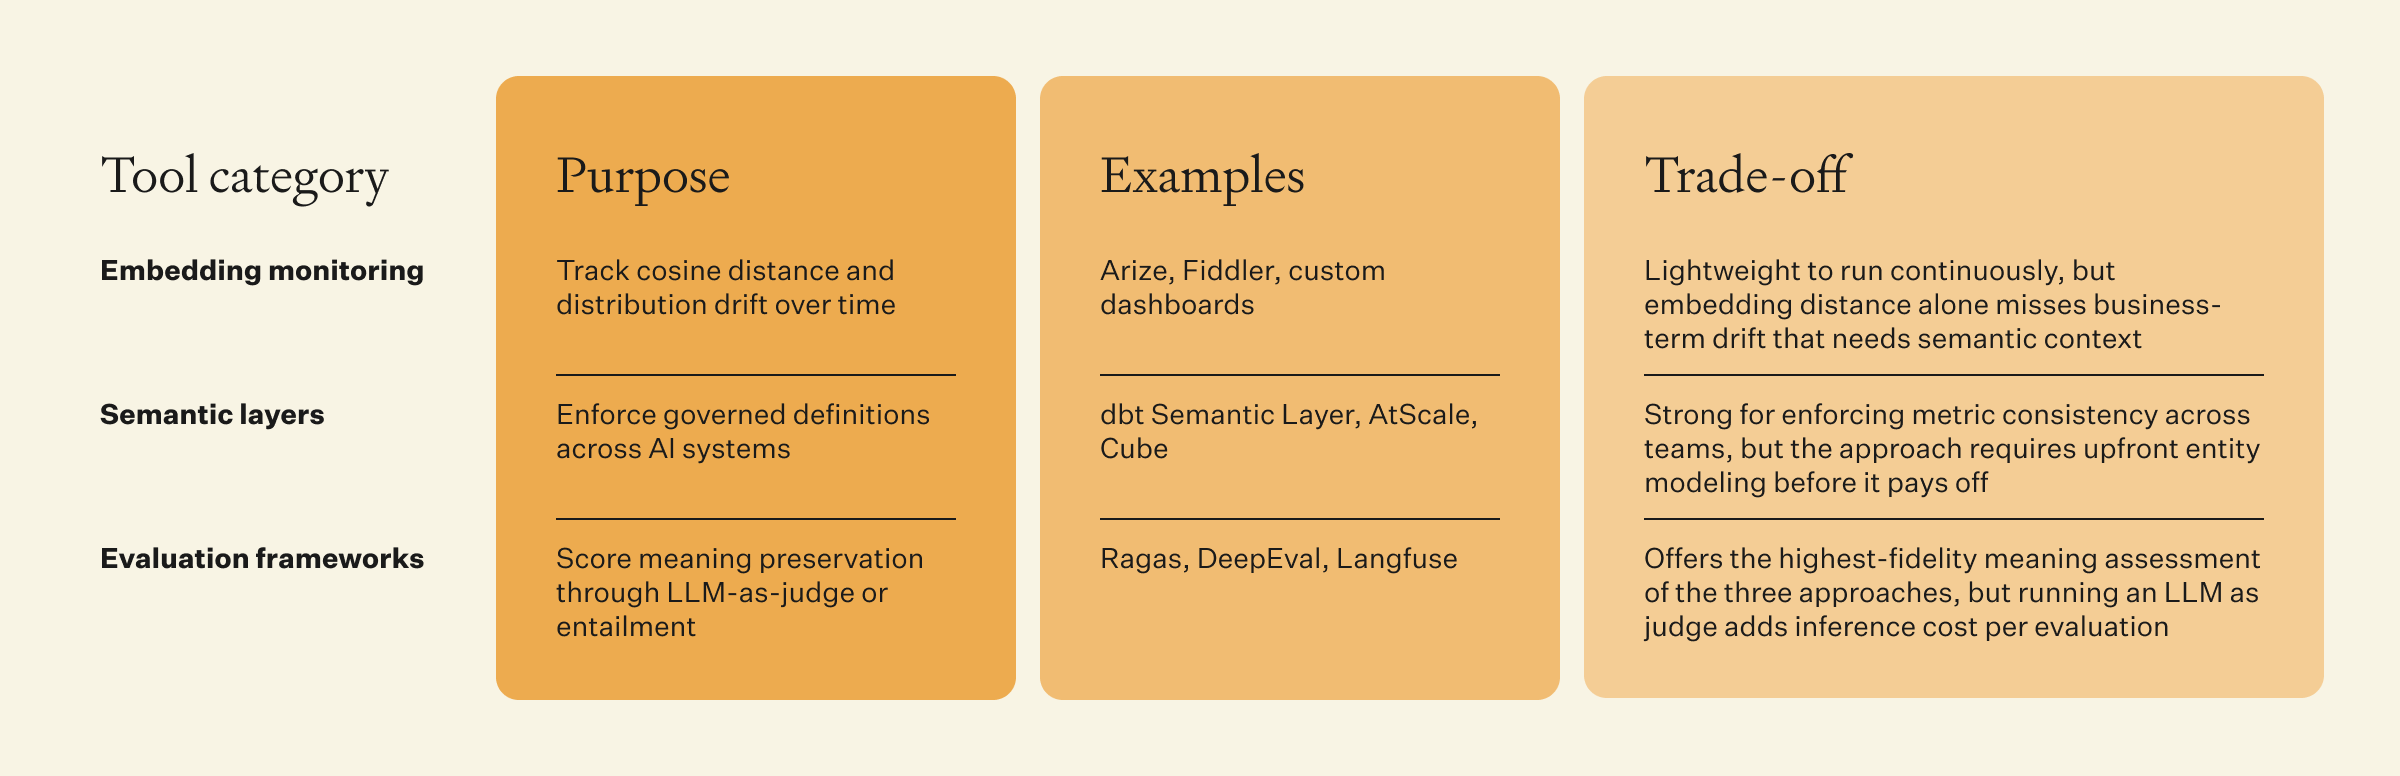
画像をクリックするとPDFで全体を表示できます
セマンティックドリフトは解決できる問題です。再トレーニングでも、ファインチューニングでもありません。規律ある意味の維持の指標と、チーム横断の用語ガバナンスによって解決するのです。
セマンティックドリフトは積み重なっていくため、早期の検知が重要です。1週目のわずかな意味のずれが、3か月目には重大な不一致になります。早い段階でドリフトを捉えている組織は、精度だけでなく意味を監視している組織です。
具体的な次のステップは、今週中に1つのビジネス用語、または1つのエージェントワークフローを選ぶことです。参照となる意味を定義し、セマンティック類似度のダッシュボードを設定して、30日間ドリフトを測定します。そのベースラインを使って、アラートのしきい値を設定しましょう。
Dataikuは、監視、評価、ガバナンスを統合し、ドリフトした意味が本番環境での意思決定に届く前に捉えます。
意味の一貫性があれば、AIシステムは同じ定義を使い、共有された用語を同じように解釈できます。これがないと、2つのダッシュボードが1つの指標について異なる数値を示し、組織が意図した意味から静かに乖離した出力に基づいて意思決定が行われてしまいます。
セマンティックドリフトを早期に捉えるアプローチは3つあります。大きな変化を捉える埋め込み距離の継続的な監視、細かなドリフトを捉える参照出力に対する定期的なセマンティック類似度スコアリング、そしてマルチターンの会話におけるドリフトを捉える含意チェックです。精度指標だけでは、意味がドリフトしていても安定したままのことがあるため、3つすべてを組み合わせましょう。
それだけでは解決できません。再トレーニングは、新しいデータで重みを更新することで、モデルドリフト、つまり精度の低下を解決します。セマンティックドリフトは文脈の蓄積や定義の変更から生じるため、まず定義と文脈のレイヤーで対処し、精度にも改善が必要な場合に再トレーニングを行いましょう。
セマンティックレイヤーは、ビジネス用語ごとにガバナンスされた1つの定義を、その用語を参照するすべてのAIシステムに適用します。「解約率」などの定義が変わると、その更新はバージョン管理され、自動的に反映されます。これにより、各チームが独自の定義を持つことで起こるバラバラなドリフトを防ぎます。
いいえ。言語、ビジネス上の定義、データはいずれも変化していくため、ある程度のドリフトは避けられません。目指すべきは排除ではなく管理です。継続的な監視によって早期に検知し、ガバナンスされた定義によって最悪のケースを防ぎ、見つかったら迅速に是正しましょう。
ハルシネーションは、生成された時点で誤っている、事実に基づかないコンテンツです。セマンティックドリフトは、意味が徐々に乖離していくことです。そのため、先月は正しかった出力が、意味が変わったことで今は誤りになることがあります。ハルシネーションのチェックは出力を情報源と照合し、ドリフトのチェックは意味を参照となる意図と経時的に照合します。