AIにおけるグラウンディング検証:セマンティック整合性チェックのためのLLM手法
October 9, 2026/読了時間10分/Team Dataiku
RAGパイプラインは、取得したドキュメントにモデルの出力をグラウンディングすることで、ハルシネーションを減らします。しかし、モデルがそれらのドキュメントを忠実に使ったかどうかまでは保証できません。回答に引用が付き、グラウンディングチェックを通過していても、根拠とするソースの内容を誤って伝えている場合があります。検証は、単にソースがある回答と、ソースを正確に反映した回答との違いを見極めるレイヤーです。
このギャップは測定可能です。847件のエンタープライズRAG導入事例を対象とした業界分析(2026年2月のコンソーシアム調査を引用したAI Magicxの報告)によると、RAGはハルシネーションを中央値で71%削減します。検証は、それでも残る失敗を特定するのに役立ちます。
本ガイドでは、セマンティック整合性を評価し、AIが生成した出力への信頼を高めるために組織が使える主要な概念、メトリクス、検証手法、実装のプラクティスを解説します。
グラウンディングは、モデルの出力を外部のソースに結び付けます。グラウンディング検証は、その結び付きが主張単位で成り立っているかを確認します
セマンティック整合性チェックは、生成された主張を、取得したソースの内容と意味レベルで比較します
検証品質の評価に役立つメトリクスは、サポートスコア(忠実性)、引用適合率、引用再現率の3つです
4つのLLMグラウンディング手法で、検証を多層化できます。RAGパイプライン、生成後のファクトチェックAPI、主張単位のスコアリング、ヒューマンインザループのレビューです
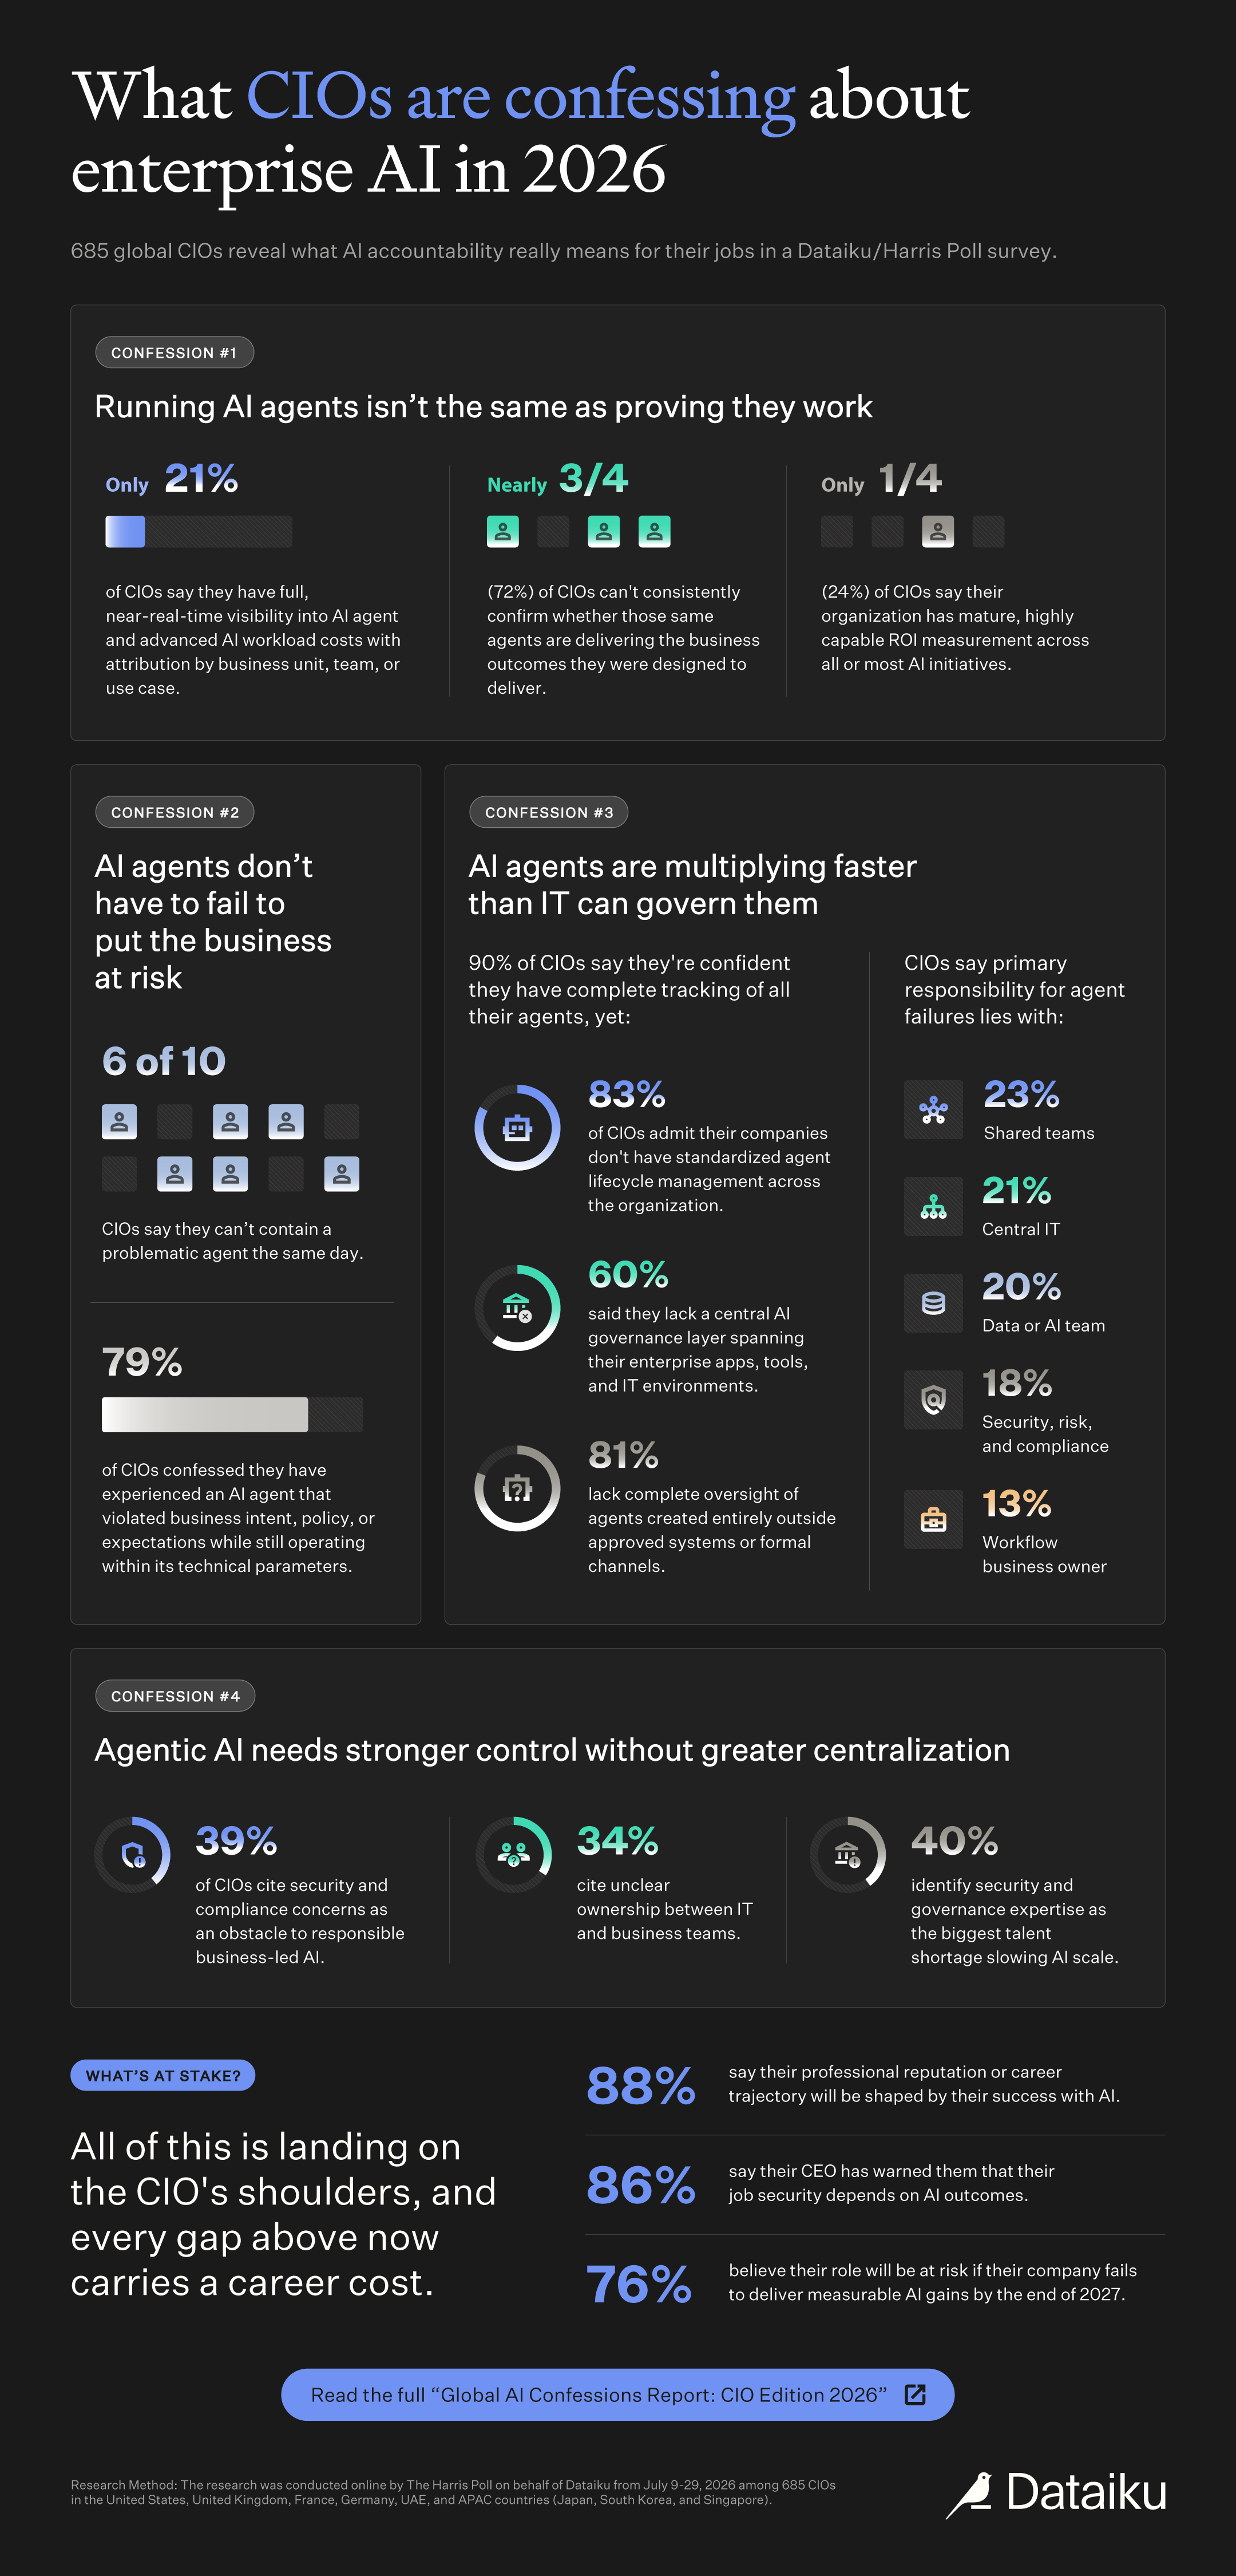
Dataiku/Harris Pollの調査に基づく「Global AI confessions report: data leaders edition」によると、AIの出力が常に100%追跡可能だと答えたデータリーダーはわずか5%です。グラウンディング検証は、残りの出力の監査可能性を高めるのに役立ちます
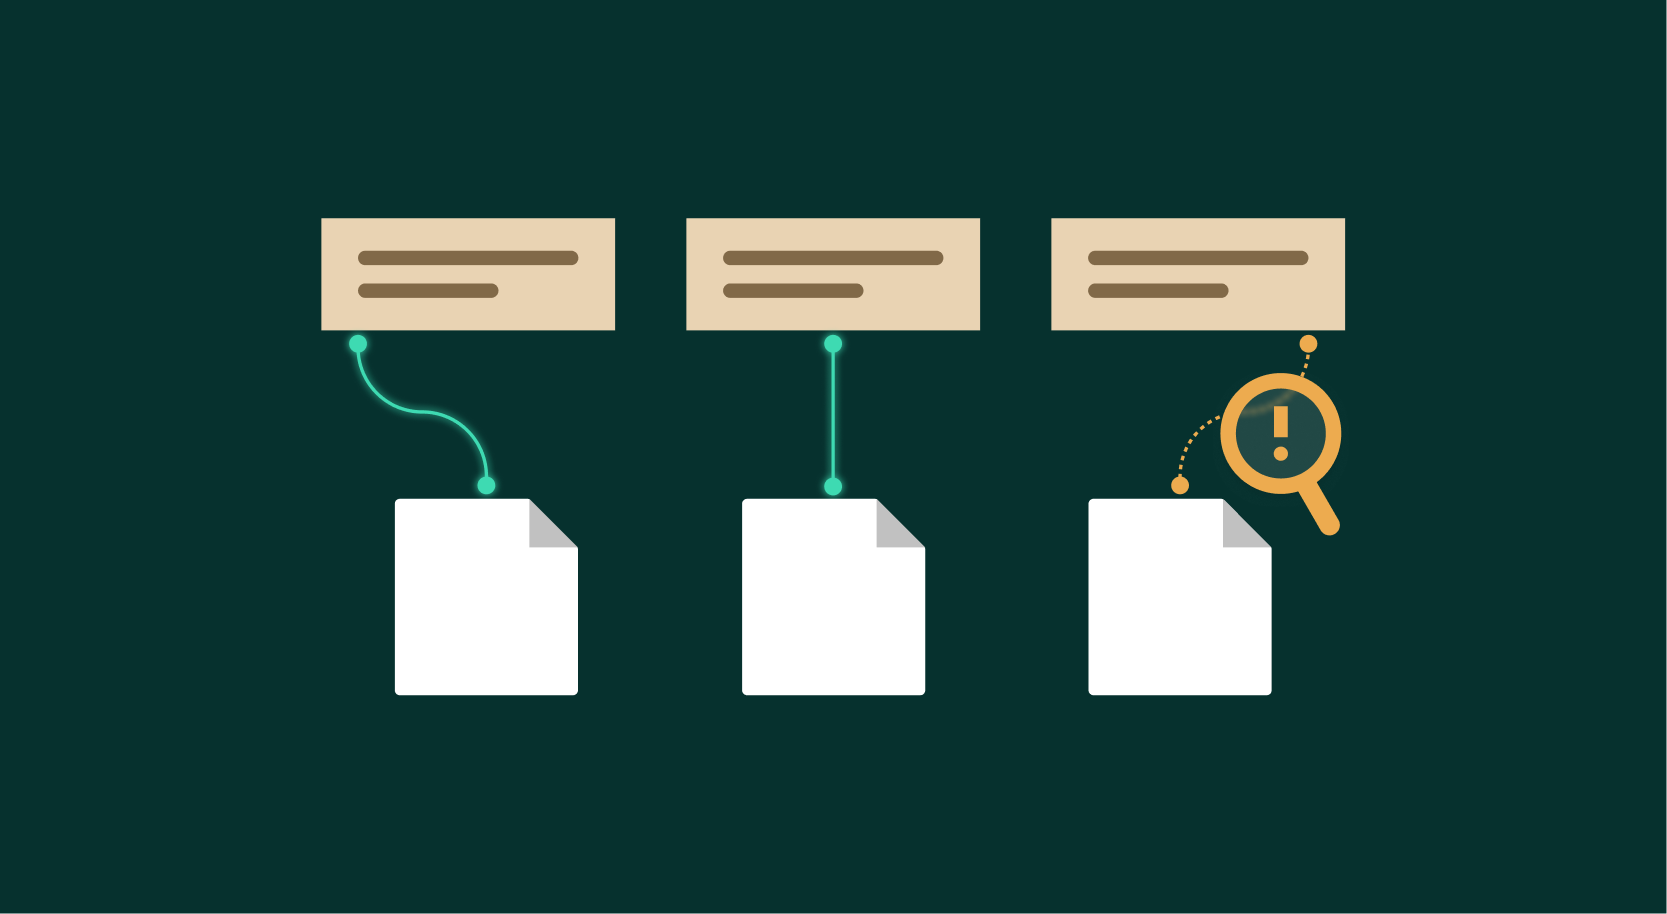
グラウンディング検証とは、AIが生成した出力に含まれる主張が、システムが生成時に使ったソースの根拠によって裏付けられているかを評価するプロセスです。これはグラウンディングそのものではなく、グラウンディングの上に位置する検証レイヤーです。
グラウンディングとは、関連するドキュメントを取得し、コンテキストとしてモデルに提供するアーキテクチャーパターン(一般的にはRAG)です。グラウンディング検証は、モデルの出力が取得したドキュメントの内容を反映しているかを評価する品質チェックです。
RAGシステムが適切なドキュメントを取得しても、グラウンディングされていない回答を生成することがあります。取得によって示されるのは根拠が利用可能だったことであり、モデルがそれを正しく使ったことまでは示さないためです。
モデルは、取得した2つのパッセージの情報を、どちらのパッセージも裏付けていない形で統合したり、ソースを誤って言い換えたり、取得した事実の間のギャップを、もっともらしいものの根拠のない推論で埋めたりすることがあります。いずれの場合も、グラウンディングは適切な根拠をモデルに提示するという役割を果たしています。モデルがその根拠を忠実に使ったかを確認するのが検証です。
グラウンディング検証では、生成された主張が、モデルのパラメトリックメモリー(トレーニングデータ)ではなく、検索コーパスの外部事実に対応しているかを評価します。検証は、RAGパイプライン(取得したドキュメントの使われ方を確認)、ツール利用(ツールの出力が正確に表現されているかを確認)、AIのソース帰属(引用したソースが、帰属させた主張を実際に裏付けているかを確認)と関係します。
セマンティック整合性チェックは、生成された主張を、取得したソースの内容と意味レベルで比較します。生成されたテキストがソース資料から論理的に導かれ、裏付けられているかを評価するものです。
セマンティック整合性は、事実の正確性よりも狭い概念です。回答がソースとセマンティックに整合していても(すべての主張が取得したドキュメントにたどれる)、事実としては誤っている(ソースドキュメント自体に誤りがある)場合があります。
検証で確認するのはソースとの整合性です。事実の正確性にはソース自体が正確であることが必要で、これは検証の問題ではなくデータ品質の問題です。
比較の基準は意味レベルの整合性です。生成された主張は、ソース資料の意味を保っているでしょうか。逐語的な照合では、有効な言い換えを見逃します。キーワードの重複では、意味のずれを見逃します。意味レベルの比較は、有効な言い換えと意味のずれの両方を捉えるのに適しています。
金融アドバイザーのチャットボットが規制文書を引用しながら、その条件を誤って言い換え、重要な制限を逆の意味にしてしまったとします。引用は存在します。ソースも正しいものです。しかし、生成された主張はソースと矛盾しています。セマンティック整合性チェックがなければ、この回答は権威があり引用も付いているように見えますが、実質的には誤っています。
一貫性のない回答がもたらすビジネスリスク:
信頼の喪失:ユーザーがAIの出力を信用しなくなる
コンプライアンス上のギャップ:自らの引用と矛盾する出力が、規制上のリスクを生む
業務の無駄:下流のプロセスが一貫性のない情報に基づいて動き、手作業での照合が必要になる
セマンティック整合性チェックは、グラウンディングだけでは見逃す主張を捉えることで、ハルシネーションを減らします。また、引用付きの回答が、引用の裏付ける内容を正しく述べるようにすることで、ユーザー満足度を高めます。
グラウンディング検証が効果的に機能しているかは、3つのメトリクスで判断できます。
サポートスコアは、生成された回答が提供された根拠によってどの程度裏付けられているかを、0から1のスケールで測定します。実装はさまざまです。例えば、GoogleのCheck Grounding APIは、回答ごとに1つのサポートスコアを返します。
シンプルな社内スコアリング手法の1つは、生成された回答を個々の主張に分解し、各主張を「裏付けあり(1)」「一部裏付けあり(0.5)」「裏付けなし(0)」でスコアリングして、すべての主張の平均値を求める方法です。
support_score = sum(claim_scores) / total_claims
しきい値の例:
金融、法務、ヘルスケアなどリスクの高いアプリケーションでは、0.90以上など、より高いしきい値を設定する場合があります
一般的なエンタープライズアプリケーションでは、誤りがもたらす影響に応じて、より低いしきい値を許容できる場合があります
スコアが低い場合は、調査や人によるレビューのトリガーとして使えます。よく参照される出発点の1つは0.70です
引用適合率は、引用されたソースのうち、それが付いている主張を実際に裏付けているものの割合を測定します。5つのソースを引用していても、それぞれの主張を裏付けているのが3つだけであれば、引用適合率は0.60です。
citation_precision = correctly_supporting_citations / total_citations
ターゲット:本番稼働のアプリケーションでは0.90超。適合率が低い場合、モデルが裏付けのためではなく、見せかけのためにソースを引用していることを示します。
引用再現率は、回答に含まれる主張のうち、裏付けとなる引用があるものの割合を測定します。10の主張のうち6つにしか引用がない回答の引用再現率は0.60で、4つの主張は検証できないことになります。
citation_recall = cited_claims / total_claims
ターゲット:規制対象の環境では1.0(すべての主張が追跡可能である必要があります)。一般的なエンタープライズ用途では0.80超。
4つの検証手法は、それぞれ異なる精度とコストのトレードオフに対応します。最も高い保証レベルの実装では複数の手法を組み合わせ、低コストの手法を事前フィルターとして、高コストの手法をリスクの高い検証に使います。
RAGは、関連するドキュメントを取得し、コンテキストとしてモデルに渡すことで、グラウンディングの基盤となるレイヤーを提供します。RAGにおける検証では、モデルの出力が取得した内容を反映しているかを確認します。
検証チェックポイント:生成後、出力内の各主張を、セマンティック類似度または含意スコアリングを使って取得したパッセージと比較します。類似度のしきい値を下回る主張には、グラウンディングされていない可能性があるとしてフラグを立てます。
レイテンシーに関する考慮事項:検証パスを追加すると、エンドツーエンドのレイテンシーが増加します。ユーザー向けアプリケーションでは、追加される検証のレイテンシーを、アプリケーションに求められる体験の要件と照らして評価してください。
ファクトチェックAPIは、提供された事実のセットに対して生成された回答をスコアリングし、サポートスコアと、どの事実がどの主張を裏付けているかを返します。GoogleのCheck Grounding APIは、最も成熟した例です。
APIは3つの入力を受け取ります:
回答候補:生成された回答
事実:取得したパッセージ、またはナレッジベースのエントリー
引用しきい値:引用に含めるための最小信頼度
APIは、サポートスコア、回答内のバイトオフセット位置付きの引用チャンク、主張単位の帰属を返します。
サポートスコアが定義したしきい値を下回った場合は、自動的にリジェクトするようトリガーを設定します。リジェクトされた回答はフォールバック(異なる検索での再生成、人によるレビューへのエスカレーション、または「検証できません」という回答の返却)に回します。
主張単位のスコアリングでは、回答を個々の文または主張に分解し、それぞれをソース資料と個別に照らして評価します。これは回答単位のスコアリングよりも粒度の細かい手法です。全体で80%グラウンディングされた回答にも、まったく裏付けのない主張が1つ含まれている可能性があり、回答単位のスコアリングではそれが平均化されて見えなくなります。
しきい値の調整:ドメインのリスク許容度に基づいて、主張ごとのしきい値を設定します。リスクの高いアプリケーションではより厳しいしきい値を使い、一般的なエンタープライズアプリケーションでは、スコアの低い主張を自動的にリジェクトせず、レビュー対象としてフラグを立てる運用も可能です。
実装上の注意:主張の分解では、非ASCII文字を含むアーティファクトや、一貫性のないバイトオフセットが生じる場合があります。UIでのハイライトや監査ログに使う前に、元の回答テキストとオフセットを照合して検証してください。
自動検証だけでは不十分なリスクの高いドメインでは、専門のレビュアーが定期的に回答をサンプリングし、構造化されたルーブリックに沿って評価できます。
レビューのルーブリック:
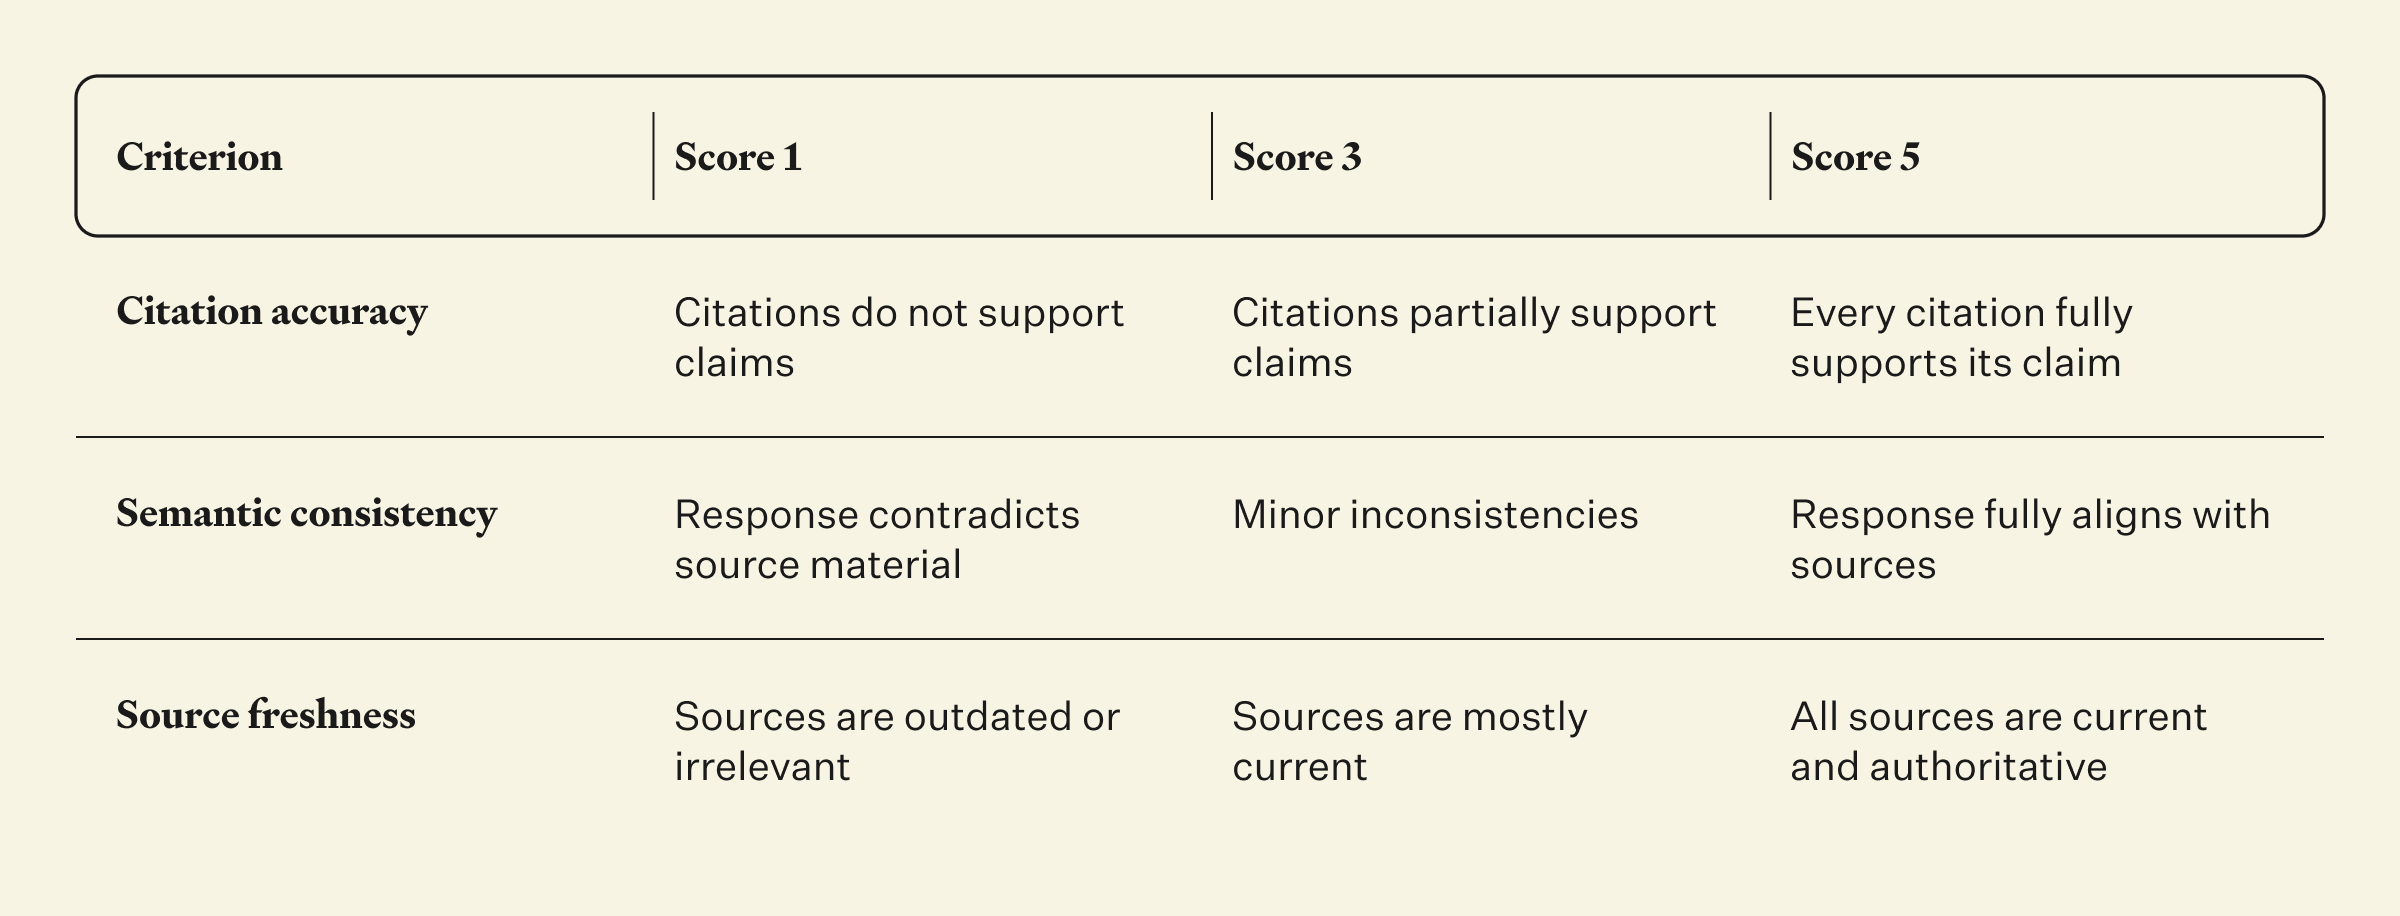
レビュー結果は検索のチューニングにフィードバックされます。特定の種類のソースからのグラウンディングの品質が低いとレビュアーが繰り返し判断した場合、そのソースはレビュー対象としてフラグが立てられるか、検索コーパスから除外されます。
グラウンディング検証APIを使った最小限の実装で、基本的なパターンを示します。
import requests
import json
def verify_grounding(answer: str, facts: list[str], threshold: float = 0.7):
"""Score answer against facts and return verification result."""
payload = {
"answerCandidate": answer,
"facts": [{"content": f} for f in facts],
"citationThreshold": threshold
}
response = requests.post(
"https://your-grounding-api/v1/check",
headers={"Authorization": f"Bearer {API_KEY}"},
json=payload
)
result = response.json()
return {
"support_score": result.get("supportScore", 0),
"cited_chunks": result.get("citedChunks", []),
"is_grounded": result.get("supportScore", 0) >= threshold
}
使用例
facts = [
"The EU AI Act's high-risk obligations take effect August 2, 2026.",
"Fines for non-compliance reach 15 million euros or 3% of turnover."
]
answer = "The EU AI Act's high-risk requirements become enforceable in August 2026, with penalties up to 15 million euros."
result = verify_grounding(answer, facts)
print(f"Support score: {result['support_score']}")
print(f"Grounded: {result['is_grounded']}")回答内のsupportScoreは、提供された事実によって回答がどの程度裏付けられているか(0.0~1.0)を示します。citedChunks配列は、どの事実が回答のどの部分を裏付けているかを、UIでのハイライト用の文字オフセットとともに示します。
認証の前提条件はAPIプロバイダーによって異なります。GoogleのCheck Grounding APIを使うには、Discovery Engine APIを有効にしたGoogle Cloudプロジェクトが必要です。
グラウンディングの品質を長期的に維持するための6つのプラクティスを紹介します。以下の範囲は普遍的なしきい値ではなく、実践的な出発点です。チームは、自社のデータ、リスクプロファイル、モデルスタック、レイテンシー要件に合わせて調整する必要があります。
検証の品質は、システムが照合する事実に大きく左右されます。コンテンツの変動性に応じて、更新頻度を設定します:
日次:変化の速いコンテンツ(価格、在庫、ポリシーの更新)
週次:中程度に変化するコンテンツ(製品ドキュメント、FAQ)
月次:安定したコンテンツ(規制文書、技術仕様)
本番稼働のアプリケーションでは、引用適合率90%超をターゲットにします。適合率は毎週追跡します。持続的な低下があれば調査してください。適合率の低下は、多くの場合、検索品質の劣化を示します(システムが、問われているクエリを裏付けないドキュメントを取得している状態です)。
大きすぎる事実(ドキュメント全体を1つの事実として渡すもの)は、検証の精度を下げます。多くの主張を含み、その一部しか関連しない大きなパッセージから、モデルが裏付けを主張できてしまうためです。ソース資料を約200~500トークンの意味的にまとまったセグメントにチャンク化することで、検証の適合率を高められます。
完全な主張単位の検証では、実装によって回答ごとに約200~500ミリ秒が追加される場合があります。レイテンシーが重要なアプリケーションでは、段階的な検証を実装します。すべての回答に軽量な埋め込みベースのチェックを行い、10%のサンプルに完全な主張単位のスコアリングを適用し、軽量チェックで潜在的な問題にフラグが立った場合は、完全なスコアリングを自動的にトリガーします。
平均サポートスコアが定義したベースラインを下回った場合に通知する、しきい値ベースのアラートを設定します。1週間で5%の持続的な低下があれば調査が必要です。10%低下した場合は、検索パイプラインとソースコーパスを直ちに見直す必要があります。
AIサクセスのためのプラットフォームであるDataikuは、ガバナンスの効いたデータ基盤の上に構築された、グラウンディングされたエンタープライズQ&A機能を提供します。回答はソース帰属付きでエンタープライズのナレッジベースから生成できます。プラットフォームのガバナンス機能により、チームはそれらのナレッジソースのキュレーションと維持、アクセス管理を行えます。
5つの落とし穴と、それぞれの対策を紹介します。
ソースコーパスに古い情報や矛盾する情報が含まれていると、検証は誤った事実との整合性を確認してしまいます。
対策:すべてのソースドキュメントに鮮度メタデータを付与します。定義した有効期限を過ぎたソースには、フラグを立てるか除外します。
取得したパッセージをモデルのコンテキストに渡しすぎると、シグナルが薄まります。モデルが最も関連性の高いパッセージではなく、関連性の低いパッセージから統合してしまう可能性があります。その結果、技術的には取得した内容にグラウンディングされていても、利用可能な最良の根拠にはグラウンディングされていない回答が生成されます。
対策:コンテキストを、関連性の高い上位3~5件のパッセージに絞ります。再ランキングを使い、量より質を確保します。
以前の状態を反映したソース資料が、最新のものとして提示されるケースです。6か月前には正確だったものの、その後改訂されたポリシー文書は、グラウンディングされているにもかかわらず誤った回答を生み出します。
対策:
必要に応じて、ソースドキュメントにタイムスタンプを付与する
引用とあわせて、ソースの日付を表示する
検証パスが、定義した鮮度のしきい値より古いソースに依存している場合は、アラートを出す
ソースドキュメントを指してはいるものの、付与された特定の主張を裏付けていない引用です。ソースは存在します。引用の形式も正しいものです。しかし、裏付けの関係が成り立っていません。
対策:主張単位のスコアリングでは、引用されたソースが存在するかだけを確認するのではなく、引用と主張のペアをそれぞれ個別に評価することで、この問題を捉えます。
自動検証はグラウンディングの失敗の大半を捉えますが、微妙なケースは見逃します。意味をわずかに変える言い換え、ソースが明示していない含意、正確な情報を文脈に合わない形で適用するケースなどです。
対策:リスクの高いドメインでは、自動検証に人によるレビューを重ねます。
グラウンディング検証は、AIが生成した回答が引用した根拠によって正確に裏付けられているかを評価する、品質管理のレイヤーです。主張単位で適用すれば、裏付けのない記述を特定しやすくなり、回答とソース資料の間のトレーサビリティーを高められます。組織は、各アプリケーションのリスクと監査要件に基づいて、サポートスコア、引用適合率、引用再現率のターゲット値を設定できます。
具体的な次のステップは次のとおりです。本番稼働のRAGアプリケーションを1つ選び、検証のコード例を100件の回答に対して実行し、サポートスコアの分布を測定します。このベースラインから、AIの出力のうち実際にグラウンディングされている部分と、そう見えるだけの部分の割合がわかります。
Dataikuは、評価と組み込みの監視機能によって、AIアプリケーションをガバナンスの効いたデータにグラウンディングします。これにより、すべての回答を根拠までたどることができ、すべての根拠ソースをそのガバナンス記録までたどることができます。
ユーザーがAIの生成した回答に基づいて行動するアプリケーションでは、本番環境へのデプロイ前に実装すべきです。デプロイ後の検証は、問題を事後的に捉えます。デプロイ前の検証は、問題がそもそもユーザーに届くのを防ぎます。
はい。検証は、事実のソースにかかわらず、生成された主張と提供された事実の関係を評価します。エンタープライズのナレッジベース、社内wiki、ポリシー文書、独自のデータベースはすべて、事実レイヤーとして機能します。
すべての主張を監査可能にすることで高めます。ユーザーとレビュアーは、各主張をどのソースが裏付けているかを確認し、裏付けの関係を検証し、裏付けのない主張を特定できます。信頼の根拠は「AIがそう言ったから」から「AIがそう言い、その根拠がここにある」へと変わります。
はい、ある程度は増えます。完全な主張単位の検証では、実装によって、回答ごとに約200~500ミリ秒の遅延と、1回の追加API呼び出しが発生する場合があります。段階的な検証(すべての回答に軽量チェック、サンプルに完全なスコアリング)によって、このトレードオフを管理できます。
金融サービス(規制コンプライアンス、アドバイスの正確性)、ヘルスケア(臨床意思決定支援、患者向け情報)、法務(判例調査、契約分析)、そしてAIが生成した回答が、監査対象となる重大な意思決定に影響するあらゆる業界です。
Tags