AIによる文書処理の自動化
December 16, 2024/11分で読了/Guillaume Cazottes
企業は大量の重要情報を文書として蓄積しています。これらの文書(報告書、契約書、請求書、メールなど)は人間向けに設計されており、自動処理が困難です。しかし、文書に特化したAI分野であるDocument AIは急速に進化しており、文書処理の自動化が現実のものとなっています。この記事では、最新のドキュメントAI(Document AI)が提供する可能性の一端をご紹介します。具体的には、以下の点について説明します。
ドキュメントAIの適用範囲を明確にします
その主要なアプローチを紹介します
主要なドキュメントAIタスクを具体的に実行する方法を示します
説明した技術のほとんどを実装するDataikuのサンプルプロジェクトを紹介します
なお、複数ページにわたる文書に対する質疑応答システムの構築については、「Data From the Trenches」の過去の記事で既に取り上げているため、この記事では扱いません。ご了承ください。
ドキュメントAI(文書理解とも呼ばれる)とは、スキャンされた文書や元々デジタル形式の文書を自動的に分析し、分類したり、そこから情報を抽出したりすることを指します。ドキュメントAIの主要なタスクには、以下のようなものがあります。
光学文字認識(OCR):画像に含まれるテキストを機械が読み取れるテキストに変換すること
レイアウト分析:文書の構造を分析すること。とくに、段落、見出し、表、画像などの要素を検出し分類すること
文書分類:文書の内容に基づいて、請求書、フォーム、メールなど、あらかじめ定められたカテゴリに分類すること
ビジュアル質問応答(VQA):モデルが文書の視覚的な内容に基づいて質問に答えるタスク
重要情報抽出:非構造化文書から特定の構造化データ(名前、日付、価格など)を抽出するプロセス
文書の扱いは、主に3つの理由で困難です。第一に、通常、テキストと画像(図、グラフなど)が組み合わされていること。第二に、構造が暗黙的で、レイアウトによって示唆されるだけであることが多いこと。第三に、多様な形式(レイアウト、フォントファミリー、フォントサイズなど)があることです。これらの障害を克服するために、ドキュメントAIはコンピュータービジョンと自然言語処理の両方の手法を活用し、文書を単なる画像、単なるテキスト、またはその両方の組み合わせとして扱います。
ドキュメント解析のためのAIアプローチ
アプローチ代表的なモデルどのような場合に適しているかコンピュータービジョンVision Transformer、畳み込みニューラルネットワーク (CNN)● タスク遂行に「全体像」のみが必要な場合(文書分類やレイアウト分析でよく見られるケース)自然言語処理 (NLP)大規模言語モデル(LLM、例:GPTのような自己回帰型LLMやBERTのような自己符号化型LLM)● 文書の視覚的要素(画像、レイアウトなど)がタスク遂行に不可欠ではない場合マルチモーダルアプローチマルチモーダルLLM(例:GPT-4o)、Layout Transformer● タスク遂行に文書の視覚的要素とテキスト要素の両方の理解が必要な場合● 文書の視覚的要素の理解だけで十分だが、タスクの入力または出力が自由形式のテキストである場合(例:ビジュアル質問応答)● より高いレイテンシ(遅延)や計算コストが許容できる場合
このセクション以降では、オープンソースのパッケージ、オープンウェイトのモデル、またはプロプライエタリなAPIベースのLLMを使用して、ドキュメントAIタスクを実行する方法をいくつかの例で示します。まず、レイアウト分析から始めます。これは、単純ではないレイアウトを持つ文書から意味のあるOCR結果を得るための重要な前提条件です。
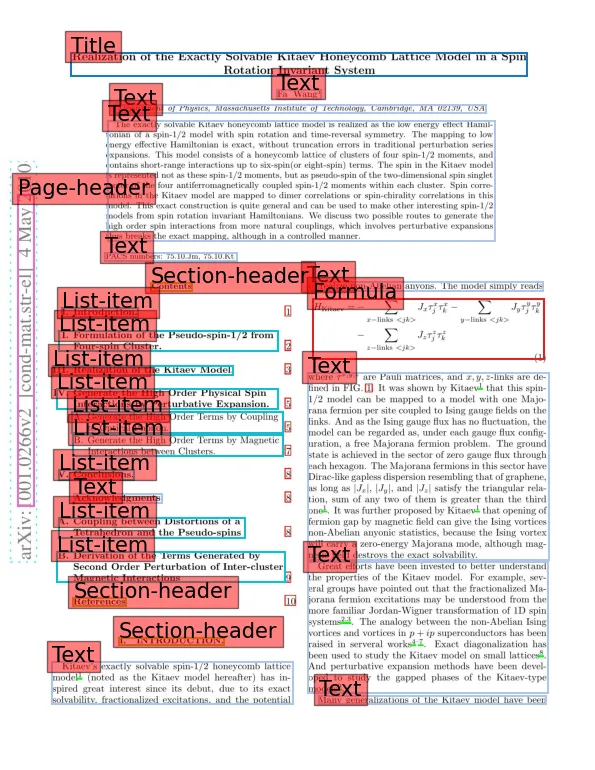
現在のレイアウト分析のアプローチは、とくに文書内のオブジェクト検出用にファインチューニングされたコンピュータービジョンモデルに依存しています。代表的なクラスには、「タイトル」、「テキスト」、「ページヘッダー」、「セクションヘッダー」などがあります。例えば、Pythonライブラリのunstructuredは、これらのモデルのいくつかを簡単に利用できるように提供しており、さらにさまざまなドキュメント形式を解析・処理するための他の機能も備えています。
レイアウト解析後のドキュメント
OCRに関しては、直接的なアプローチとして、最近公開されたオープンウェイトのTransformerモデルGOTや、有名なオープンソースライブラリTesseractに組み込まれているLSTMモデルのような、特化した深層学習モデルを使用する方法があります。これらのモデルは軽量で高速、かつ効果的です。
しかし、その性能はユースケースの実際の状況に依存します。特定の言語や、手書き文字と印刷文字の両方に対してうまく機能するかどうかは、その訓練データセットによります。例えば、Tesseractは手書き文書に対してはあまり効果的ではありません。さらに、以下のような画像の前処理ステップが必要になる場合があります。
レイアウト分析を用いて、文書内のさまざま
なテキストボックスを分離する
ハフ変換を用いて、テキストの向きを修正する
視覚的なノイズ(すなわち、目下のタスクにとって無関係な詳細)を除去する
文書のスケール、明るさ、コントラストを調整する
近年登場した強力なマルチモーダルLLM(M-LLM)は、これらの特化したOCRモデルの代替手段を提供します。GPT-4oやInternVLのようなオープンウェイトモデルなどのM-LLMを使えば、対象の画像をプロンプトに含めて、モデルにテキスト内容を抽出するように依頼するだけで済みます。性能レベルは、特化モデルと同様にユースケースによって異なりますが、一般的に非常に高いです。
しかし、M-LLMは時折、2つの望ましくない挙動を示すことがあります。第一に、文書から抽出されたテキストに、「画像内のテキストは...」のような独自のコメントを追加することがあります。第二に、元の文書でスペルミスとみなされる単語を修正したり、内容を「幻覚(ハルシネーション)」したりすることさえあります。これらの問題は両方とも、プロンプトの調整やLLM出力の後処理が必要になる場合があります。
さまざまなOCRアプローチの利点と欠点
Tesseractローカルホスト特化モデル (例: GOT)ローカルホストM-LLM (例: InternVL)APIベース プロプライエタリ M-LLM (例: GPT-4o)利点● オープンソース● オンプレミス処理可能● 高速● 印刷文書での信頼性の高い性能● GPU不要● オープンウェイト● オンプレミス処理可能● 印刷・手書き両文書で強力な性能● オープンウェイト● オンプレミス処理可能● 印刷・手書き両文書で強力な性能● 使いやすい● 印刷・手書き両文書で強力な性能欠点● 手書き文書や低品質文書での性能が低い● プロンプト依存● 不要なコメントが追加されることがある● 望まないスペル修正● GPUを備えたローカルインフラが必要● 高コスト
Qwen2-VLやGPT-4oのようなM-LLM(マルチモーダル大規模言語モデル)も、文書を事前に定義されたカテゴリリスト(例:記事、メール、手紙、フォーム)に分類するための強力な選択肢です。この場合、プロンプトには、文書を分類する指示、カテゴリのリスト、分類対象の文書ページ、そして場合によってはfew-shotの例(すなわち、いくつかの文書ページとその正解ラベル)が含まれます。指定したカテゴリのなかから1つのカテゴリに分類されることが期待されるため、関数呼び出し(function calling)や構造化出力(structured outputs)などの構造化テキスト生成技術を使用して、不正な回答のリスクを軽減または排除することが推奨されます。
十分なサイズの訓練データセットが利用可能な場合は、モデルをファインチューニングすることも可能です。オープンウェイトモデルであるUDOP(Universal Document Processing)は、ドキュメントAIタスクの有力な候補です。UDOPはOCRエンジン(デフォルトではTesseract)を使用し、テキスト、レイアウト、画像をインプットとして処理します。これは、文書分類、レイアウト分析、ビジュアル質問応答、重要情報抽出、文書生成など、さまざまなタスクを実行できる汎用性の高いモデルです。とくに訓練データセットが比較的小さい場合は、LoRAのようなparameter-efficient fine-tuning(PEFT)技術を使用する方が通常は良いでしょう。
さまざまな文書分類アプローチの利点と欠点
ローカルでホストするファインチューニングを実施した文書モデル (例: UDOP)ローカルでホストするM-LLM (例: Qwen2-VL)APIベース プロプライエタリ M-LLM (例: GPT-4o)>利点● オープンウェイト● 多数の訓練例を活用できる● 非常に特化したタスクに対応可能少数の訓練例または訓練例なしで使用可能● オープンウェイト● 使いやすい欠点● 十分な訓練データセット、専門知識、GPUを備えたローカルインフラが必要● M-LLMの事前訓練コーパスでカバーされていない可能性が高い、非常に特化したタスクには不適切● GPUを備えたローカルインフラが必要● とくにfew-shot例がプロンプトに含まれる場合、GPUメモリ消費が大きい● とくにfew-shot例がプロンプトに含まれる場合、コストが高い
ここでは、質問と一緒に提供される単一ページから回答が得られる質問に限定します。文書全体をカバーする質問応答システムは、通常、マルチモーダルな検索拡張生成(RAG)アプローチを必要としますが、これは以前のブログ記事で既に取り上げられています。Qwen2-VLやGPT-4oのようなM-LLM(マルチモーダル大規模言語モデル)は、質問の潜在的な性質が一般的であること、何らかのテキストコンテンツを生成する必要があること、ページの視覚的要素とテキスト要素の両方を考慮する必要があることから、ビジュアル質問応答タスクに適した手法です。対象とするドメインが非常に特殊な場合はファインチューニングされることもありますが、最近のM-LLMはzero-shot設定であっても、一般的に良好な回答を生成します。
質問応答システムの品質評価は、同等に妥当な回答が非常に異なる方法で表現されうるため、とくに困難です。最良のアプローチは、一般的にLLM-as-a-judge(審査員としてのLLM)技術を使用すること、すなわち、生成された回答を評価し、利用可能な場合は正解(ground-truth)と比較するようLLMに依頼することです。
重要情報抽出タスクでは、文書ページ(例:レシートのスキャン)が与えられ、そこから特定の事前に定義された情報(例:会社名と住所、レシートの日付、レシートの金額など)を抽出しようとします。M-LLM(マルチモーダル大規模言語モデル)、(例:ここでもQwen2-VLやGPT-4o)は、このタスクのように回答がかなり自由形式(open-ended)である場合に役立つテキスト生成能力のおかげで、このタスクにおいても有力な候補です。ファインチューニングは役立つこともありますが、必須ではないことが多いです。
この文脈では、M-LLMは通常、ターゲットフィールドと正確に対応するプロパティをもつJSONオブジェクトを生成するようにプロンプト入力されます。文書分類の場合よりもさらに、期待される形式に従うためには、関数呼び出し(function calling)や構造化出力(structured outputs)のような構造化テキスト生成技術が不可欠です。
Dataikuユーザーは、Dataikuプロジェクトギャラリーの公開され再利用可能なサンプルプロジェクトを通じて、上記で述べたさまざまな技術の探索を開始できます。具体的には、このプロジェクトでは以下の手法を見ることができます。
Unstructured、InternVL、GPT-4oを使用してレイアウト分析とOCRを実行する
文書分類のためにUDOPをファインチューニングするか、GPT-4oまたはQwen2-VLを活用する
GPT-4oまたはQwen2-VLを使用して文書に基づいた質問に回答し、対応する回答を評価する
GPT-4oまたはQwen2-VLを使用して文書から特定のフィールドを抽出する
これらの機能をシンプルなWebアプリケーションで公開する
ドキュメントAIにおける最近の進歩により、ますます広範なタスクの自動化が可能になっています。数年前にはとくに困難だったであろうユースケースが実現可能になっています。この文脈において、M-LLM(マルチモーダル大規模言語モデル)はその汎用性、使いやすさ、zero-shotまたはfew-shot能力、そして高性能さで際立っており、この分野でますます重要な役割を果たす可能性が高いです。それでも、とくにリアルタイムのユースケースや、M-LLMの計算コストが過大となる低リソース環境においては、いくつかの代替手段が依然として有効です。
Tags