ディープラーニングをより深く理解する
13分で読めます
人工知能(AI)について調べていると、ときにわかりにくい用語のせいで、話がどんどん複雑に感じられることがあります。AIという言葉は、機械学習(ML)やディープラーニングといった用語と一緒に、ときには同じ意味で使われることもあります。
ディープラーニングのようなテーマを掘り下げるには、まず定義を確認し、そのうえで次の点を理解する必要があります。
ディープラーニングと、関連するAIの概念(生成AIを含む)との違い
ディープラーニングを使うべき場面と使うべきでない場面
ディープラーニングを考えるうえで、教師あり学習と教師なし学習についても知っておくべき理由
組織での機械学習とディープラーニングの導入をDataikuがどのように支援できるか
ディープラーニングとは何でしょうか。ディープラーニングと人工知能はどう違うのでしょうか。ディープラーニングは生成AIや強化学習とどのような関係にあるのでしょうか。
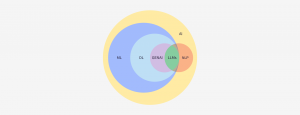
簡単に言えば、ディープラーニングは機械学習の一分野であり、機械学習はAIの一分野です。ディープラーニングは生成AIの構成要素でもあります。生成AIの一種である大規模言語モデル(LLM)はトランスフォーマーネットワークの一種であり、トランスフォーマーはディープラーニングに特化したアーキテクチャーです。より簡単に言えば、LLMはディープラーニングの手法を用いたアルゴリズムです。つまりディープラーニングは、AIの一種であるだけでなく、生成AIの根幹でもあります。
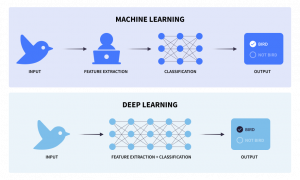
線形回帰やロジスティック回帰、ランダムフォレスト、勾配ブースティングといった従来の機械学習アルゴリズムは、統計的手法に基づいています。機械はこの手法により、ラベル付きのトレーニングデータから、特定の予測やクラスタリングのタスクを実行する方法を反復的に学習します。このアプローチでは通常、データサイエンティストやドメインエキスパートが、モデルで使用する特徴量(変数)を手作業で抽出、設計、選択する必要があります。この工程は、どの機械学習プロジェクトでも時間がかかりがちです。
ディープラーニングは、機械学習のなかでもより新しく専門的な分野です。多数の層を持つニューラルネットワークアーキテクチャー(「ディープニューラルネットワーク」と呼ばれることが多い)を使って、データ内の複雑なパターンをモデル化します。代表的なディープニューラルネットワークには、畳み込みニューラルネットワーク(CNN)、再帰型ニューラルネットワーク(RNN)、トランスフォーマーネットワークがあります。
従来の機械学習モデルとは異なり、ディープラーニングモデルは生データから特徴量を直接抽出する方法を自動で学習できます。そのため手作業による特徴量エンジニアリングの必要性が減り、テキスト、画像、動画、音声などの非構造化データを扱う用途で大きな力を発揮します。ディープラーニングモデルは、画像認識や音声認識、自然言語処理(NLP)、複雑なゲームのプレイといったタスクで優れた性能を示し、従来の機械学習手法を上回ることもあります。一方で、モデルはより複雑で計算負荷が高く、通常は大量のトレーニングデータとGPUなどの専用ハードウェアを必要とします。
当然ながら、より複雑なデータを扱うには、より複雑なアルゴリズムが必要です。複雑なデータから十分に汎用的なパターンを抽出するには、機械学習モデルよりもはるかに多くの(本当に多くの)サンプルが必要です。目安として、ディープラーニングモデルをゼロからトレーニングするには、通常、数万から数百万枚のラベル付き画像が必要になります。
ディープラーニングが登場したからといって、従来の機械学習モデルを捨てるわけではありません。構造化された表形式のデータだけを扱う多くの一般的な予測タスクでは、よりシンプルで計算負荷も低い機械学習のアプローチのほうが、ディープラーニングより適しています。
わかりやすい例を挙げましょう。マンハッタンからブルックリンに行くとき、歩くべきでしょうか、それとも飛行機で飛ぶべきでしょうか。これは、かかるコストや時間と、得たい結果とのシンプルなトレードオフです。マンハッタンからブルックリンまで飛行機で行くのは、「シンプルな」問題にディープラーニングモデルを使うのと同じことです。つまり、この問題に対してはまったく効率的ではありません。
ディープラーニングと生成AIは密接に関係しており、ディープラーニングは生成AIを支える基盤技術です。多層のニューラルネットワークを用いるディープラーニングは、大規模なデータセットから複雑なパターンを学習することに優れています。
生成AIでは、敵対的生成ネットワーク(GAN)やトランスフォーマーアーキテクチャー(GPTなど)といったディープラーニングモデルが、既存のデータから学習し、テキストや画像などの新しいコンテンツを生成します。要するに、ディープラーニングは、生成AIがリアルで独創的な出力を生み出すための高度なモデルアーキテクチャーの土台となっています。
強化学習もディープラーニングと同じく機械学習の一分野です。強化学習では、エージェントが累積報酬を最大化する行動をとることで、意思決定の方法を学習します。エージェントは環境と相互作用し、報酬またはペナルティーという形でフィードバックを受け取り、それに基づいて行動を調整します。よくある例はゲームのプレイです。
強化学習はディープラーニングと組み合わせることもできます(深層強化学習)。この場合、ディープニューラルネットワークを使って方策や価値関数を表現します。これはとくに、自動運転やビデオゲームのように状態空間と行動空間が複雑かつ高次元で、従来の強化学習の手法ではうまくいかない環境で役立ちます。深層強化学習は、画像のピクセルや音声のような生のセンサー入力を扱う場合にも有用です。前述のとおり、ディープラーニングのアルゴリズムが特徴量の抽出を行うため、手作業による特徴量エンジニアリングが不要になるからです。
ディープラーニングは急速に普及しています。とくに人工ニューラルネットワークの分野での大きなブレークスルーを受けて、業界を問わず多くの企業がAI戦略の一環としてディープラーニングのソリューションを導入するようになりました。
カスタマーサービスのチャットボットから小売業の画像認識や物体認識まで、ディープラーニングを基盤とする高度なAIアプリケーションが数多く登場しています。その機会と可能性は明らかですが、ディープラーニングは常に正しい選択なのでしょうか。
膨大なデータを必要とする複雑なタスクでのディープラーニングアルゴリズムの優れた性能に加え、公開データで事前学習されたモデルが増えていることから、ディープラーニングは多くの企業にとってとくに魅力的なものになっています。しかし、これから見ていくように、ディープラーニングがあらゆるビジネス課題の答えになるわけではありません。
では、ディープラーニングが必要なときとそうでないときを、どう見分ければよいのでしょうか。ユースケースはそれぞれ異なり、具体的なビジネス目標、AI成熟度、スケジュール、データ、リソースなどによって左右されます。以下では、ある課題の解決にディープラーニングを使うかどうかを決める前に考慮すべき、4つの一般的なポイントを紹介します。
ディープラーニングの主な利点の1つは、複雑な問題を解決できることです。例えば、データに隠れたパターンを見つける必要がある問題や、相互に依存する多数の変数間の複雑な関係を深く理解する必要がある問題です。ディープラーニングのアルゴリズムは、データから隠れたパターンを自ら学習し、それらを組み合わせて、はるかに効率的な判断ルールを構築できます。
ディープラーニングがとくに力を発揮するのは、画像分類、NLP、音声認識など、大量の非構造化データを扱うことが多い複雑なタスクです。
特徴量エンジニアリングがより単純で、非構造化データの処理を必要としないシンプルなタスクには、従来の機械学習のほうが適している場合があります。
ディープラーニングでは、特徴量抽出の多くをアルゴリズムが自動で行うため、特徴量エンジニアリングにかかる人の手間は確かに減ります。その一方で、モデルが何をしているのかを人が理解し、解釈することは難しくなります。前述のとおり、解釈可能性はディープラーニングの最大の課題の1つです。
機械学習モデルを評価する際には、通常、精度と解釈可能性の間に根本的なトレードオフがあります。これこそが説明可能なAIの課題の核心です。ディープネットワークは多くの分野で従来の機械学習手法をはるかに上回る精度を達成しています。しかし、非線形性が高く入力間の相互作用も多い非常に複雑な状況をモデル化しているため、解釈することはほぼ不可能です。
一方、従来の機械学習では特徴量を直接設計し、線形回帰やロジスティック回帰、決定木など、より解釈しやすい機械学習アルゴリズムも利用できます。そのため、データサイエンティストが内部で何が起きているかを解釈し理解するためのツールや分析手法が、より多くそろっています。
利用しやすくなってきているとはいえ、実際のディープラーニングは依然として複雑でコストのかかる取り組みです。本質的な複雑さ、多数の層、必要なデータ量の多さから、ディープラーニングモデルはトレーニングに非常に時間がかかり、大きな計算能力を必要とします。そのため、時間とリソースの両面で負荷が高くなります。
Dataikuが示した2024年のAIに関する大胆な予測の1つは、ディープラーニングのアルゴリズムを実行するには、グラフィックス処理装置(GPU)が事実上必須になったというものでした。GPUは非常に高価です。しかし、こうした複雑なモデルのトレーニングに求められる計算量とメモリー量を考えると、大規模なディープラーニングプロジェクトでは、ハードウェアアクセラレーションと、分散学習や並列学習がほぼ不可欠です。
大規模なデータセットを扱う場合やアンサンブル手法を使う場合など、一部の従来型の機械学習タスクでは、GPUや並列化によってトレーニングを高速化できます。とはいえ、多くの従来型の機械学習タスクでは分散学習は必要ありません。従来の機械学習アルゴリズムは、最高性能のハードウェアがなくても、標準的な中央処理装置(CPU)で問題なくトレーニングできます。計算コストがそれほど高くないため、企業はより速く反復し、さまざまな手法を短期間で試せます。
ディープラーニングの主な強みの1つは、より複雑なデータ型や関係を扱えることです。しかしそれは、ディープラーニングで使われるアルゴリズムがより複雑であることも意味します。繰り返しになりますが、教師あり機械学習もディープラーニングも、モデルが正解を推測しているものとは考えないようにしてください。
データから潜在的なパターンを抽出するには、大量のラベル付きサンプルを用意する必要があります。事前学習済みモデルのファインチューニングには通常数万件、モデルをゼロからトレーニングするには最大で数百万件のラベル付きサンプルが必要です。
正確にラベル付けされた高品質なデータが十分になければ、ビジネスケースによっては期待外れの結果に終わるおそれがあります。企業はデータのクレンジング、準備、ラベル付けに苦労しており、これらのプロセスにはチームの膨大な時間とリソースが費やされがちです。その時間とリソースは本来、次の機械学習モデルの構築や本番環境への展開に充てられるはずのものです。
これらの考慮事項を、あとで参照しやすいようにひとつのセクションにまとめました。
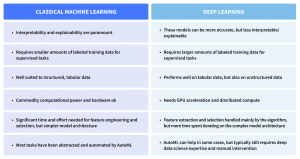
データプロジェクトで従来の機械学習とディープラーニングのどちらを選ぶにしても、共通して言えるのは、プロセスのすべてのステップで人が介入し、評価し、意思決定を行うべきだということです。人が関与するヒューマンインザループの拡張知能こそが、真に責任ある透明なAIの鍵です。
では、ディープラーニングは教師ありと教師なしのどちらなのでしょうか。答えは、どちらもあり得るということです。例えば、CNNを使った画像分類は教師ありのディープラーニングタスクです。
一方、オートエンコーダーを使った異常検知は、教師なしのディープラーニングタスクの一例です。次のセクションでは、典型的にどちらか一方になる例をいくつか見ていきます。
ここまで、セクションごとにディープラーニングへの理解を少しずつ深めてきました。多くの情報を取り上げましたが、追加のサポートなしにこれらすべてを実践するのは、さらに難しいかもしれません。
そこでDataikuの出番です。
ディープラーニングについて理解が深まったところで、実際に何ができるのかをご自身で調べ、試してみる段階です。AIを自らの手で扱えるプラットフォームであるDataikuには、ディープラーニングに取り組み始めるための機会が数多く用意されています。
AutoMLによるノーコードのソリューションから、完全にカスタマイズ可能なフルコードでのモデル構築まで、Dataikuなら、より多くの人を機械学習やディープラーニングの開発プロセスに簡単に巻き込めます。モデルの説明可能性と解釈可能性に関する機能により、モデルの結果をより深く理解し、さまざまな変数がモデルの性能に与える影響を把握し、結果をプロアクティブに監視できます。
構築済みのAutoMLテンプレートを使えば、画像分類や物体検出といった高度なディープラーニング手法や、時系列予測や因果予測といった特殊な機械学習にも、コードを書かずに簡単に取り組めます。
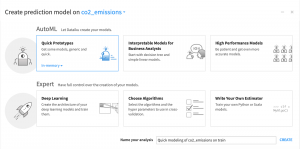
この最後のセクションでは、データのラベル付けから、ビジュアルMLやコードノートブックを使った最初のモデルの構築、転移学習によるプロセスの迅速な立ち上げまで、あらゆる側面を取り上げます。こちらのDataikuのチュートリアルで、最初のモデルを構築する方法や、NLPやビジュアルディープラーニングを試す方法を確認して、すぐにディープラーニングを始めることもできます。
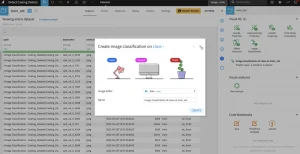
Dataikuは、コンピュータービジョンなどの定義済みのユースケース向けに、ノーコードのビジュアルなディープラーニングテンプレートを提供しています。一方、独自のタスクには、ローコードのアプローチのほうが適している場合もあります。この方法では、ディープラーニングのアーキテクチャーを定義したり、独自のデータ前処理やデータ拡張を行ったりするために、多少のコーディングスキルが必要です。それ以外はDataikuが処理します。
特徴量の処理やハイパーパラメーター探索の最適化から、モデルのデプロイやスコアリングまで、Dataikuで作成、管理される他のモデルと同じように扱えます。ディープラーニングモデルは膨大な計算能力を必要とするため、DataikuはCPUから複数のGPUまでのトレーニングに対応し、コンテナーによるデプロイ機能も備えています。クラウド上の動的なGPUクラスターで、モデルを簡単にトレーニングしてデプロイできます。
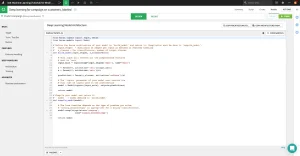
次は、Dataikuでのコーディングの無限の可能性です。この場合、DataikuはビジュアルML機能に含まれるアルゴリズムに制限をかけません。思う存分コードを書き、ずっとデプロイしたいと考えていた独自のディープラーニングモデルを構築できます。PythonやScalaで独自のモデルをコーディングすることも、前述のビジュアルMLから始めて、固有のニーズに合わせてカスタマイズしながらモデルを構築することもできます。Keras、TensorFlow、TensorBoardなど、選択肢は無限です。
最新のディープラーニングアルゴリズム、ライブラリ、環境に対する充実したサポートも用意されています。さっそくコーディングを始めましょう。
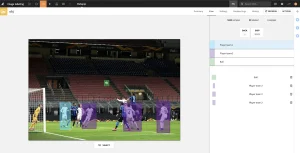
新しいモデルをトレーニングする場合も、事前学習済みモデルをファインチューニングする場合も、タスクの実行方法をアルゴリズムに教えるには大量のラベル付きデータが必要です。それを用意するのは大仕事になりがちです。まだラベル付きデータがなくても心配はいりません。
Dataikuは、組み込みのマネージドなラベリングレシピにより、データアノテーションの取り組みを効率化します。チームは表形式、テキスト、画像のデータセットに効率よくラベルを付けられます。例えば下の画像は、大きな画像のなかから特定の物体を検出する方法をモデルに教えるために、ラベル付けの担当者が対象クラスを示すバウンディングボックスで画像にアノテーションを付ける様子を示しています。
さらに、アクティブラーニングのアプローチを取り入れ、モデルの学習プロセスにとって最も情報量の多いサンプルを優先してラベル付けすることもできます。例えば、モデルが予測に最も自信を持てないレコード、観測を幅広くカバーするために入力空間のあらゆる領域から選んだレコード、データ全体の分布を代表し、汎化しやすいと考えられるレコードなどです。
アクティブラーニングは、ラベル付けのコストと労力を最小限に抑えながらモデルの性能を高められるため、ラベル付きデータが少ない場合や入手コストが高い場合にとくに有効です。
ここまで、ディープラーニングを定義し、ディープラーニングとAIなどの関連概念との違いや共通点を説明してきました。また、ディープラーニングの使用を検討すべき場面、教師あり学習と教師なし学習の違いも理解しておくべき理由、そしてDataikuのソリューションが独自の機械学習とディープラーニングのソリューションの導入をどう支援できるかも取り上げました。
機械学習、ディープラーニング、AIのどれを定義する場合でも、共通の基盤は、いずれの分野も人が主導すべきだということです。読者の皆さまのような人間がインテリジェンスに関わることこそが、真に責任ある透明なAIの鍵です。
Everyday AIは現在大きな注目を集め、データサイエンスの分野に関心と熱意をもたらしています。しかし、AIで真のインパクトを生み出すには、企業が学び続け、AI導入に向けた責任あるミッションとビジョンを築くことがきわめて重要です。
Tags