データ専門家の生産性を2倍に高める4つの方法
August 29, 2025/7分で読了/Renata Halim
データアナリストやデータサイエンティストに時間の使い道を尋ねると、答えは決まって同じです。時間の半分が、データ資産の探索、作業のやり直し、データセットやモデル、インサイトの手動ドキュメント化に費やされています。残念ながら、2025年においてもこれは依然としてデータ業務の主流となっている現実です。
何年もの間、組織はこれを背景ノイズ、すなわちスケールでアナリティクスを行う際に避けられないコストとして扱ってきました。しかし、その無駄はもはや見過ごせないほど深刻なものになっています。専門家の時間の50%が管理的な業務に費やされるとき、データ戦略は単に遅延するだけでなく、構造的にボトルネックを抱えることになります。
この背後にある課題は謎ではありません。それはすべての大規模なデータ組織に共通して現れます。メタデータの欠如、繰り返されるインサイトの生成、手作業によるドキュメント化、ビジネス上の問いとデータワークフローとの継続的な断絶などです。これらが合わさることで、データ専門知識にかかる50%の“税金”が生じています。これらの課題に体系的に取り組むことで、チームは現実的に効率を2倍に高めることができ、AIエージェントが人間と協調して確実に働ける未来への備えにもなります。
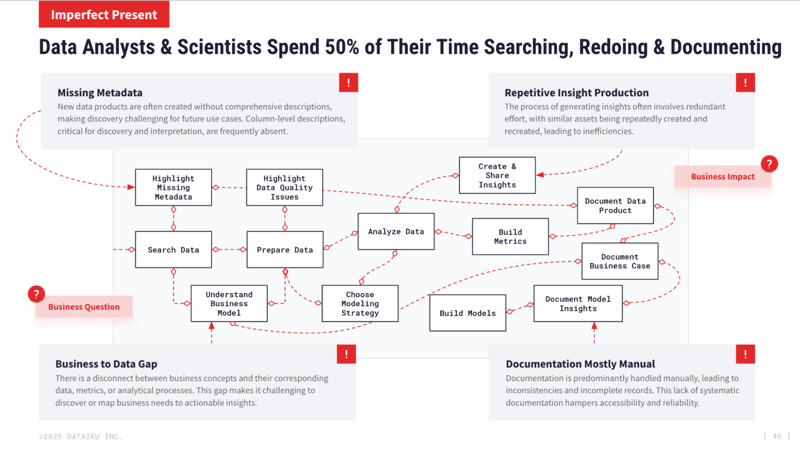
最初のボトルネックは、データ発見のプロセスです。新たなデータセットやモデルは、詳細な説明がないまま作成されることがよくあります。カラムレベルのメタデータが存在せず、リネージュが不明確なため、将来のユーザーは内容の解読に何時間も費やすことになります。多くの場合、検索を諦めてアセットを再作成し、混乱をさらに助長してしまいます。
解決策はセマンティック検索です。アナリストは、「顧客レベルで検証済みのチャーン指標を含むデータセットはどれか」といった質問を自然な言葉で尋ね、明確で文脈に沿った回答を得られるべきです。これを実現するには、単なるインデックス改善だけでは不十分です。すべてのアセットにわたるリネージュ、ドキュメント、使用履歴を結びつけるセマンティックレイヤーが求められます。
このアプローチをすでに導入している組織では、劇的な成果が見られています。オークランド・トランスポートでは、カスタマーサービスチームが1件あたり30分をかけて非構造化フィードバックを精査していました。Dataikuでセマンティック検索を導入したことで、ケースの特定は今や数秒で可能となり、180倍のスピードアップが実現しました。不完全なメタデータを推測したりアセットを再作成したりする代わりに、チームは即座に適切な文脈にアクセスし、課題を迅速に解決し、顧客との信頼関係を強化できるようになりました。
Dataikuのエンドツーエンドのプラットフォームは、データセット、モデル、インサイト全体にわたるセマンティック検索などの機能を可能にし、チームがデータ発見にかかる時間を数時間から数分に短縮できるように支援します。重複を削減し、データ発見をより効率的にすることで、チームは後工程での自動化に必要な基盤を確立できます。データ発見が強化されると、次に見えてくる課題は、インサイトを一度見つけて終わりにするのではなく、組織全体で再利用可能にすることです。
アセットが見つけやすくなると、次の課題は再利用です。分析は一度限りで作成されることが多く(例えば、単一プロジェクトのためのチャーンダッシュボードや、1回の監査用のコンプライアンスレポートなど)、数か月後にほぼ同じものが、再利用可能な形で保存されていなかったために一から作り直されるのです。
このサイクルを断ち切るには、検証済みの分析をインフラとして扱う必要があります。一時的なアウトプットとして放置するのではなく、将来のチームがすぐに適応して再活用できるテンプレートとして保存すべきです。
これがAIを活用したユースケーステンプレートライブラリのビジョンです。チャーンモデル、予測フレームワーク、コンプライアンスチェックなどの実証済みプロジェクトをカタログ化し、AIアシスタントを通じて保存、検索、再実行できるようにするのです。多くの企業がこのビジョンの実現に向けて取り組んでいる一方で、Dataikuは、共通ユースケースに対してチームがすぐに取り組めるようにするための事前構築済みソリューションを提供しており、その例はプロジェクトギャラリー(英語)にも掲載されています。
このような仕組みにより、重複を削減し、時間を節約し、一貫性を確保し、実証済みの手法をスケーラブルに展開できるようになります。再利用の仕組みが整ったところで、次の課題が浮かび上がります。それは、ドキュメントを継続的かつ信頼性のあるものにすることです。
ドキュメントは、多くの組織において依然として最も弱い部分です。手動で対応され、一貫性がなく、しばしば不完全な状態にあります。ドキュメントが体系化されていないことで、アセットの検索、信頼、再利用が困難になります。
AIによってこの状況は変わります。ドキュメントは、データセットからプロジェクト、プロダクションパイプラインに至るまで、あらゆるレベルで自動的に生成されるようになり、人間は一から作成するのではなく検証を行う役割になります。
Dataikuでは、この機能がプラットフォームに直接組み込まれています。Dataikuでは、この機能がプラットフォームに直接組み込まれています。ドキュメントが継続的かつ信頼性のあるものになることで、最後の課題――技術的成果物とビジネスニーズのギャップを埋める準備が整います。
アセットが見つけやすく、再利用可能で、ドキュメント化されていたとしても、ビジネスの言葉とデータワークフローの間には根強いギャップが存在します。アセットが見つけやすく、再利用可能で、ドキュメント化されていたとしても、ビジネスの言葉とデータワークフローの間には根強いギャップが存在します。翻訳のプロセスは遅く、ミスも起きやすいため、その断絶の中で貴重な時間が失われてしまいます。
将来の姿は、ビジネスの文脈を出力まで一貫して伴うアナリティクスです。アナリストが、一般的なビジネス課題をもとに設計されたAI支援のチャートやデータストーリーテンプレートから作業を開始する様子を想像してみてください。一から構築する必要はありません。その結果、経営層がすぐに理解できるアウトプットが、経営層向けの言葉で提示され、やり取りの手間が減り、意思決定が迅速になります。Dataiku Storiesを使えば、チームは信頼できるデータから常に最新の動的なプレゼンテーションを直接作成でき、インサイトを静的なスライドではなく、動的かつ信頼性の高いストーリーとして提供できます。
これにより、アウトプットはより迅速に生成され、ビジネスに即した言葉で表現され、一貫してドキュメント化されることで、ビジネスニーズと技術的ワークフローの間のループが閉じられます。アラインメントが解消されることで、これら4つの障壁は連動するシステムとなり、より大きな目標――信頼性の高いエージェンティックAIの活用――を可能にする基盤が整います。
これらの非効率を解消する目的は、単にスピードを上げることではありません。エージェント型AIの時代に備えることなのです。今日では、メタデータの欠如や手動によるドキュメントは煩わしいもので済みますが、明日には重大な欠陥となるでしょう。AIエージェントは、アセットが見つからず、ドキュメント化されておらず、ビジネスの文脈から切り離されている環境では効果的に機能できません。
Dataikuは、AIを発見、再利用、ドキュメント、アラインメントに組み込むことで、50%の“時間の税金”を削減しつつ、人間の専門家とAIエージェントが共に創造する未来に向けた備えを支援します。効率化は短期的なメリットに過ぎません。長期的には、従来のチームだけでは到達できない規模とインパクトを実現するチャンスがあります。
2025年に成功するリーダーは、チームの規模や運用中のモデル数では定義されません。彼らの真価は、専門家の時間の半分を浪費させている非効率を体系的に解消できる能力によって示されます。
障壁は明確です。解決策も揃っています。あとは実行あるのみです。
Dataikuを活用すれば、セマンティック検索、ユースケーステンプレート、自動ドキュメント、ビジネス文脈に基づくインサイトにより、効率を2倍にする道筋は明確です。そして効率化のその先には、よりスマートで整合性のある、未来に備えたデータ組織という、さらに大きな価値が待っています。