Deep Learning besser verstehen
13 Min. Lesezeit
Wer sich mit künstlicher Intelligenz (KI) beschäftigt, stößt schnell auf eine Fachsprache, die manchmal verwirrend ist. KI wird oft zusammen mit Begriffen wie Machine Learning (ML) und Deep Learning verwendet, manchmal sogar gleichbedeutend.
Um uns einem Thema wie Deep Learning zu nähern, definieren wir es zunächst. Danach geht es um folgende Fragen:
Die Unterschiede zwischen Deep Learning und verwandten KI-Konzepten (einschließlich generativer KI)
Wann Sie Deep Learning einsetzen sollten und wann nicht
Warum beim Thema Deep Learning auch überwachtes und unüberwachtes Lernen wichtig ist
Wie Dataiku Ihr Unternehmen bei der Implementierung von ML und Deep Learning unterstützt
Was ist Deep Learning? Worin unterscheiden sich Deep Learning und künstliche Intelligenz? Und wie hängt Deep Learning mit generativer KI und Reinforcement Learning zusammen?
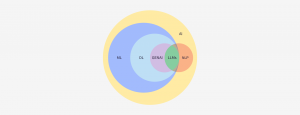
Kurz gesagt: Deep Learning ist ein Teilbereich des Machine Learning, das wiederum ein Teilbereich der KI ist. Deep Learning ist außerdem ein Baustein generativer KI. Large Language Models (LLMs), eine Form generativer KI, sind eine Art von Transformer-Netzwerk, und Transformer sind eine spezielle Deep-Learning-Architektur. Einfacher gesagt: LLMs sind Algorithmen, die mit Deep-Learning-Methoden arbeiten. Deep Learning ist also nicht nur eine Form von KI, sondern auch die Grundlage generativer KI.
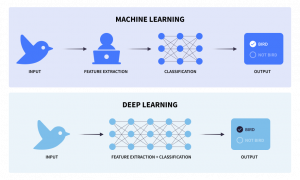
Klassische ML-Algorithmen wie lineare oder logistische Regression, Random Forest oder Gradient Boosting beruhen auf statistischen Verfahren. Mit ihnen lernen Maschinen iterativ aus gelabelten Trainingsdaten, bestimmte Vorhersage- oder Clustering-Aufgaben auszuführen. Dabei müssen Data Scientists oder Fachexperten in der Regel manuell festlegen, welche Features (Variablen) das Modell verwendet: Sie extrahieren, entwickeln und wählen sie aus. Diese Phase kann in jedem ML-Projekt viel Zeit kosten.
Deep Learning ist ein spezialisierter, modernerer Teilbereich des ML. Es nutzt neuronale Netzarchitekturen mit vielen Schichten, oft als „tiefe neuronale Netze“ bezeichnet, um komplexe Muster in Daten zu modellieren. Zu den gängigen Typen tiefer neuronaler Netze gehören Convolutional Neural Networks (CNNs), Recurrent Neural Networks (RNNs) und Transformer-Netzwerke.
Anders als klassische ML-Modelle können Deep-Learning-Modelle selbstständig lernen, Features direkt aus Rohdaten zu extrahieren. Das reduziert den Bedarf an manuellem Feature Engineering und macht sie sehr leistungsfähig für Anwendungen mit unstrukturierten Daten wie Text, Bildern, Videos oder Audio. Bei Aufgaben wie Bild- und Spracherkennung, Verarbeitung natürlicher Sprache (NLP) und komplexen Spielen übertreffen Deep-Learning-Modelle klassische ML-Methoden oft. Gleichzeitig sind sie komplexer und rechenintensiver. Meist benötigen sie große Mengen an Trainingsdaten und spezielle Hardware wie GPUs.
Komplexere Daten bedeuten natürlich auch komplexere Algorithmen. Um aus komplexen Daten ausreichend allgemeingültige Muster zu extrahieren, brauchen Sie viele (wirklich viele) Beispiele, weit mehr als für ein ML-Modell. Als Richtwert benötigen Sie typischerweise Zehntausende bis Millionen gelabelter Bilder, um ein Deep-Learning-Modell von Grund auf zu trainieren.
Mit Deep Learning werfen wir klassische ML-Modelle nicht über Bord. Für viele klassische Vorhersageaufgaben, die nur strukturierte, tabellarische Daten betreffen, eignen sich ML-Ansätze weiterhin besser als Deep Learning, da sie einfacher und weniger rechenintensiv sind.
Ein einfaches Beispiel: Wenn ich von Manhattan nach Brooklyn möchte, sollte ich dann zu Fuß gehen oder fliegen? Es geht um eine einfache Abwägung zwischen Kosten und Zeitaufwand auf der einen und dem gewünschten Ergebnis auf der anderen Seite. Von Manhattan nach Brooklyn zu fliegen entspricht dem Einsatz eines Deep-Learning-Modells für ein „einfaches“ Problem. Anders gesagt: Für dieses konkrete Problem ist es alles andere als effizient!
Deep Learning und generative KI sind eng verwandt: Deep Learning ist die grundlegende Technologie, auf der generative KI aufbaut. Deep Learning arbeitet mit neuronalen Netzen aus mehreren Schichten und lernt besonders gut komplexe Muster aus großen Datensätzen.
Im Kontext generativer KI werden Deep-Learning-Modelle wie Generative Adversarial Networks (GANs) und Transformer-Architekturen (etwa GPT) eingesetzt, um neue Inhalte zu erzeugen, ob Text, Bilder oder andere Daten. Dazu lernen sie aus vorhandenen Daten. Im Kern liefert Deep Learning die Grundlage für die anspruchsvollen Modellarchitekturen, mit denen generative KI realistische und innovative Ergebnisse erzeugt.
Wie Deep Learning ist auch Reinforcement Learning ein Teilbereich des ML. Dabei lernt ein Agent, Entscheidungen zu treffen, indem er Aktionen ausführt, die die kumulierte Belohnung maximieren. Der Agent interagiert mit seiner Umgebung, erhält Feedback in Form von Belohnungen oder Strafen und passt seine Aktionen auf Basis dieses Feedbacks an. Ein gängiges Beispiel sind Spiele.
Reinforcement Learning lässt sich auch mit Deep Learning kombinieren (Deep Reinforcement Learning). Dabei stellen tiefe neuronale Netze Policies oder Wertfunktionen dar. Das ist besonders wertvoll in Umgebungen mit komplexen, hochdimensionalen Zustands- und Aktionsräumen wie beim autonomen Fahren oder in Videospielen, wo klassische Reinforcement-Learning-Methoden an Grenzen stoßen können. Deep Reinforcement Learning ist auch dann nützlich, wenn rohe sensorische Eingaben wie Pixel in Bildern oder Audio vorliegen. Wie oben beschrieben, übernehmen Deep-Learning-Algorithmen hier die Feature-Extraktion, ohne dass manuelles Feature Engineering nötig ist.
Deep Learning hat schnell an Popularität gewonnen. Große Durchbrüche bei künstlichen neuronalen Netzen haben Unternehmen aller Branchen dazu gebracht, Deep-Learning-Lösungen als Teil ihrer KI-Strategie einzuführen.
Von Chatbots im Kundenservice bis zur Bild- und Objekterkennung im Einzelhandel: Deep Learning ist die Grundlage zahlreicher neuer, anspruchsvoller KI-Anwendungen. Chancen und Potenzial liegen auf der Hand. Aber ist Deep Learning immer der richtige Weg?
Die herausragende Leistung von Deep-Learning-Algorithmen bei komplexen Aufgaben mit enormen Datenmengen und die wachsende Verfügbarkeit vortrainierter Modelle auf Basis öffentlich verfügbarer Daten machen Deep Learning für viele Unternehmen besonders attraktiv. Wie wir sehen werden, ist Deep Learning aber nicht die Antwort auf jedes geschäftliche Problem.
Doch wie erkennt man, wann Deep Learning nötig ist und wann nicht? Jeder Use Case ist individuell und hängt unter anderem von Ihren konkreten Geschäftszielen, Ihrer KI-Reife, Ihrem Zeitplan, Ihren Daten und Ihren Ressourcen ab. Im Folgenden finden Sie vier allgemeine Überlegungen, die Sie berücksichtigen sollten, bevor Sie entscheiden, ob Sie ein bestimmtes Problem mit Deep Learning lösen.
Ein zentraler Vorteil von Deep Learning: Es kann komplexe Probleme lösen, bei denen verborgene Muster in den Daten aufgedeckt oder komplizierte Beziehungen zwischen vielen voneinander abhängigen Variablen genau verstanden werden müssen. Deep-Learning-Algorithmen lernen verborgene Muster selbstständig aus den Daten, kombinieren sie und bilden daraus deutlich effizientere Entscheidungsregeln.
Seine Stärken spielt Deep Learning bei komplexen Aufgaben aus, die oft große Mengen unstrukturierter Daten erfordern, etwa Bildklassifizierung, NLP oder Spracherkennung.
Für einfachere Aufgaben mit unkomplizierterem Feature Engineering, bei denen keine unstrukturierten Daten verarbeitet werden müssen, ist klassisches ML oft die bessere Wahl.
Deep Learning reduziert zwar den menschlichen Aufwand für Feature Engineering, da der Algorithmus einen Großteil der Feature-Extraktion automatisch übernimmt. Gleichzeitig wird es für Menschen schwieriger, nachzuvollziehen und zu interpretieren, was das Modell tut. Wie bereits erwähnt, ist die Interpretierbarkeit sogar eine der größten Herausforderungen von Deep Learning.
Bei der Bewertung jedes ML-Modells gilt es in der Regel, grundsätzlich zwischen Genauigkeit und Interpretierbarkeit abzuwägen. Genau darin liegt die Kernfrage von erklärbarer KI (Explainable AI). Tiefe Netze erreichen in vielen Bereichen eine Genauigkeit, die weit über der klassischer ML-Methoden liegt. Da sie jedoch sehr komplexe Situationen mit starker Nichtlinearität und Wechselwirkungen zwischen den Eingaben modellieren, sind sie kaum zu interpretieren.
Beim klassischen ML hingegen werden Features direkt entwickelt, und es gibt besser interpretierbare Machine-Learning-Algorithmen wie lineare oder logistische Regressionen und Entscheidungsbäume. Data Scientists stehen deshalb mehr Werkzeuge und Analysen zur Verfügung, um zu interpretieren und zu verstehen, was im Hintergrund passiert.
Trotz besserer Zugänglichkeit bleibt Deep Learning in der Praxis ein komplexes und teures Unterfangen. Aufgrund ihrer Komplexität, der vielen Schichten und der großen Datenmengen lassen sich Deep-Learning-Modelle nur sehr langsam trainieren und benötigen viel Rechenleistung. Das macht sie sehr zeit- und ressourcenintensiv.
Eine zugespitzte These von Dataiku zu KI im Jahr 2024 lautete, dass Grafikprozessoren (GPUs) für die Ausführung von Deep-Learning-Algorithmen praktisch unverzichtbar geworden sind. GPUs sind sehr teuer. Doch wegen der hohen Rechen- und Speicheranforderungen beim Training dieser komplexen Modelle sind Hardwarebeschleunigung und ein verteiltes oder parallelisiertes Training für große Deep-Learning-Projekte nahezu unerlässlich.
GPUs und Parallelisierung können das Training mancher klassischer ML-Aufgaben beschleunigen, etwa bei großen Datensätzen oder Ensemble-Methoden. Viele klassische ML-Aufgaben benötigen jedoch kein verteiltes Training. Klassische ML-Algorithmen lassen sich mit einem ordentlichen Hauptprozessor (CPU) ganz normal trainieren, ohne Spitzenhardware. Da sie weniger rechenintensiv sind, können Unternehmen außerdem schneller iterieren und verschiedene Verfahren in kürzerer Zeit testen.
Eine der größten Stärken von Deep Learning ist der Umgang mit komplexeren Datentypen und Beziehungen. Das bedeutet aber auch, dass die verwendeten Algorithmen komplizierter sind. Auch hier gilt: Betrachten Sie weder überwachtes Machine Learning noch Deep Learning als ein Modell, das die richtige Antwort errät.
Um latente Muster aus Daten zu extrahieren, müssen Sie viele gelabelte Beispiele bereitstellen: typischerweise Zehntausende gelabelte Samples für das Fine-Tuning eines vortrainierten Modells oder bis zu Millionen für das Training eines Modells von Grund auf.
Ohne einen ausreichend großen Bestand an präzise gelabelten, hochwertigen Daten riskieren Sie in manchen Business Cases enttäuschende Ergebnisse. Das Bereinigen, Aufbereiten und Labeln von Daten stellt Unternehmen vor Herausforderungen. Diese Prozesse binden in den Teams oft enorm viel Zeit und Ressourcen, die besser in die Entwicklung der nächsten ML-Modelle oder deren Überführung in die Produktion fließen würden.
Wir haben alle diese Überlegungen in einem praktischen Abschnitt zusammengefasst, auf den Sie später zurückgreifen können:
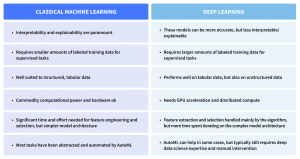
Ob Sie sich für ein Datenprojekt für klassisches ML oder Deep Learning entscheiden: In jedem Schritt des Prozesses sollten Menschen eingreifen, bewerten und entscheiden. Erweiterte Intelligenz mit dem Menschen im Prozess (Human in the Loop) ist der Schlüssel zu wirklich verantwortungsvoller und transparenter KI.
Ist Deep Learning also überwacht oder unüberwacht? Beides ist möglich. Bildklassifizierung mit einem CNN ist zum Beispiel eine überwachte Deep-Learning-Aufgabe.
Anomalieerkennung mit Autoencodern ist dagegen ein Beispiel für eine unüberwachte Deep-Learning-Aufgabe. Im nächsten Abschnitt sehen wir uns einige Beispiele an, bei denen es typischerweise das eine oder das andere ist.
Abschnitt für Abschnitt haben wir unser Verständnis von Deep Learning vertieft. Das sind viele Informationen, doch sie ohne weitere Unterstützung in die Praxis umzusetzen, kann noch schwieriger sein.
Hier kommen wir ins Spiel.
Jetzt, da Sie mehr über Deep Learning wissen, ist es an der Zeit, seine Möglichkeiten in der Praxis selbst zu erkunden. Mit Dataiku, der Plattform, mit der Sie KI selbst in die Hand nehmen, haben Sie viele Möglichkeiten, mit Deep Learning zu starten.
Von No-Code-Lösungen mit AutoML bis zum vollständig anpassbaren Modellbau mit Code: Mit Dataiku lassen sich mehr Menschen einfach in die Entwicklung von ML- und Deep-Learning-Modellen einbinden. Dank Funktionen für Erklärbarkeit und Interpretierbarkeit von Modellen verstehen Sie Modellergebnisse besser, erkennen den Einfluss verschiedener Variablen auf die Modellleistung und überwachen Ergebnisse proaktiv.
Mit vorgefertigten AutoML-Vorlagen steigen Sie einfach in fortgeschrittene Deep-Learning-Verfahren wie Bildklassifizierung oder Objekterkennung ein, ebenso wie in spezielle ML-Verfahren wie Zeitreihenprognosen oder kausale Vorhersagen. Und das ganz ohne Programmierkenntnisse.
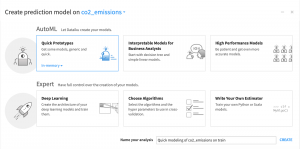
In diesem letzten Abschnitt behandeln wir alle Aspekte: vom Labeln Ihrer Daten über die Entwicklung Ihres ersten Modells mit Visual ML oder Code-Notebooks bis zum schnellen Einstieg mit Transfer Learning. Sie können auch direkt mit Deep Learning loslegen. In diesen Dataiku-Walkthroughs lernen Sie, Ihr erstes Modell zu erstellen, NLP zu erkunden oder Visual Deep Learning zu nutzen.
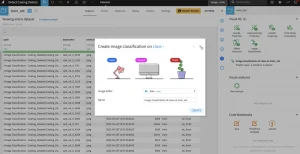
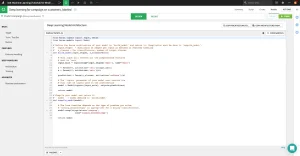
Dataiku bietet visuelle No-Code-Vorlagen für Deep Learning in vordefinierten Use Cases wie Computer Vision. Für individuelle Aufgaben passt jedoch möglicherweise der Low-Code-Weg besser zu Ihren Anforderungen. Dafür brauchen Sie etwas Programmierkenntnisse, um die Deep-Learning-Architektur zu definieren oder eine individuelle Datenvorverarbeitung oder Datenanreicherung (Augmentation) durchzuführen. Um den Rest kümmert sich Dataiku.
Von der Verarbeitung der Features und der Optimierung der Hyperparametersuche bis zum Deployment und Scoring: Das Modell wird wie jedes andere in Dataiku erstellte und verwaltete Modell behandelt. Da Deep-Learning-Modelle so viel Rechenleistung benötigen, unterstützt Dataiku das Training auf CPUs bis hin zu mehreren GPUs sowie über Container-Deployment. Sie können Modelle einfach auf dynamischen GPU-Clustern in der Cloud trainieren und bereitstellen.
Als Nächstes die unbegrenzten Möglichkeiten der Programmierung in Dataiku. Programmieren Sie nach Herzenslust und entwickeln Sie das individuelle Deep-Learning-Modell, das Sie schon immer bereitstellen wollten. Denn hier beschränkt Dataiku Sie nicht auf die Algorithmen seiner Visual-ML-Funktionen. Sie können Ihr eigenes Modell in Python oder Scala programmieren oder mit dem oben beschriebenen Visual ML beginnen und Ihr Modell an Ihre spezifischen Anforderungen anpassen. Keras, TensorFlow, TensorBoard und mehr: Ihnen stehen alle Möglichkeiten offen!
Dabei werden Sie umfassend mit den neuesten Deep-Learning-Algorithmen, Bibliotheken und Umgebungen unterstützt. Legen Sie los!
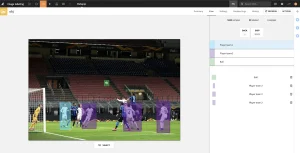
Wenn Sie ein neues Modell trainieren oder ein vortrainiertes Modell feintunen, benötigen Sie viele gelabelte Daten, um dem Algorithmus Ihre Aufgabe beizubringen. Diese zu beschaffen kann aufwendig sein. Wenn Sie noch keine gelabelten Daten haben, keine Sorge!
Dataiku vereinfacht Datenannotation mit einem integrierten, verwalteten Labeling-Recipe, mit dem Teams tabellarische, textbasierte oder bildbasierte Datensätze effizient labeln. Die folgende Abbildung zeigt zum Beispiel, wie eine Person beim Labeling ein Bild mit Begrenzungsrahmen für relevante Klassen versieht. So lernt das Modell, bestimmte Objekte in einem größeren Bild zu erkennen.
Sie können sogar einen Active-Learning-Ansatz umsetzen, um für das Labeling die Samples zu priorisieren, die für den Lernprozess des Modells am aufschlussreichsten sind. Dazu gehören Records, bei denen sich das Modell seiner Vorhersagen am wenigsten sicher ist, Records aus allen Bereichen des Eingaberaums für eine vielfältige Abdeckung der Beobachtungen sowie Records, die für die gesamte Datenverteilung repräsentativ sind und voraussichtlich gut generalisieren.
Active Learning ist nützlich, weil es die Modellleistung verbessert und gleichzeitig Kosten und Aufwand für das Labeling minimiert. Das ist besonders wertvoll, wenn gelabelte Daten knapp oder teuer zu beschaffen sind.
Wir haben Deep Learning definiert und die Unterschiede und Gemeinsamkeiten mit anderen Konzepten wie KI besprochen. Wir haben gezeigt, wann sich Deep Learning eignet, warum Sie auch den Unterschied zwischen überwachtem und unüberwachtem Lernen kennen sollten und wie die Lösungen von Dataiku Sie bei der Implementierung eigener ML- und Deep-Learning-Lösungen unterstützen.
Ob ML, Deep Learning oder KI: Allen gemeinsam ist, dass sie vom Menschen gesteuert sein sollten. Den Menschen, also Sie, in die Intelligenz einzubinden, ist der Schlüssel zu wirklich verantwortungsvoller und transparenter KI.
Everyday AI erlebt derzeit einen Hype und lenkt Aufmerksamkeit und Begeisterung auf den Bereich Data Science. Trotzdem ist es für Unternehmen sehr wichtig, sich weiterzubilden und eine verantwortungsvolle Mission und Vision für den Einsatz von KI zu entwickeln, um tatsächlich Wirkung zu erzielen.
Tags